전체 54
#GCP 16
#클라우드튜링 9
#Node.js 9
#장애 분석 8
#GKE 8
#Kubernetes 7
#보안 6
#Valkey 6
#아키텍처 5
#Cloud Run 5
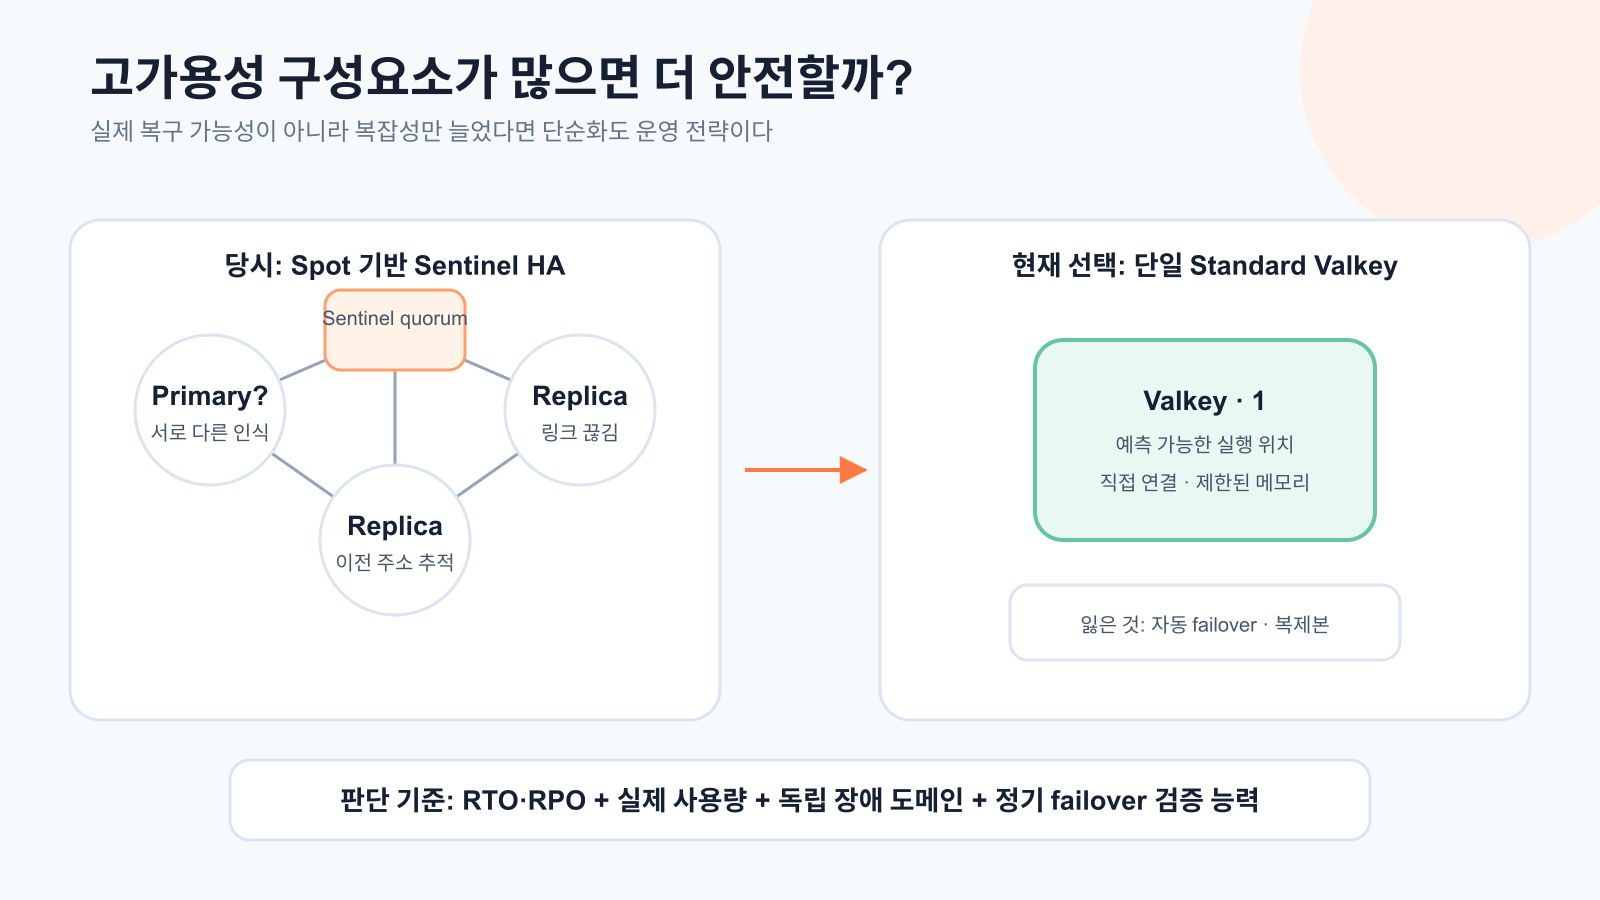
고가용성을 단순화했다: Valkey Sentinel을 제거한 이유
Spot 선점 뒤 Sentinel의 primary 인식과 replication이 갈라진 경험을 바탕으로, 단일 Standard Valkey를 선택한 조건과 포기한 것을 정리합니다.
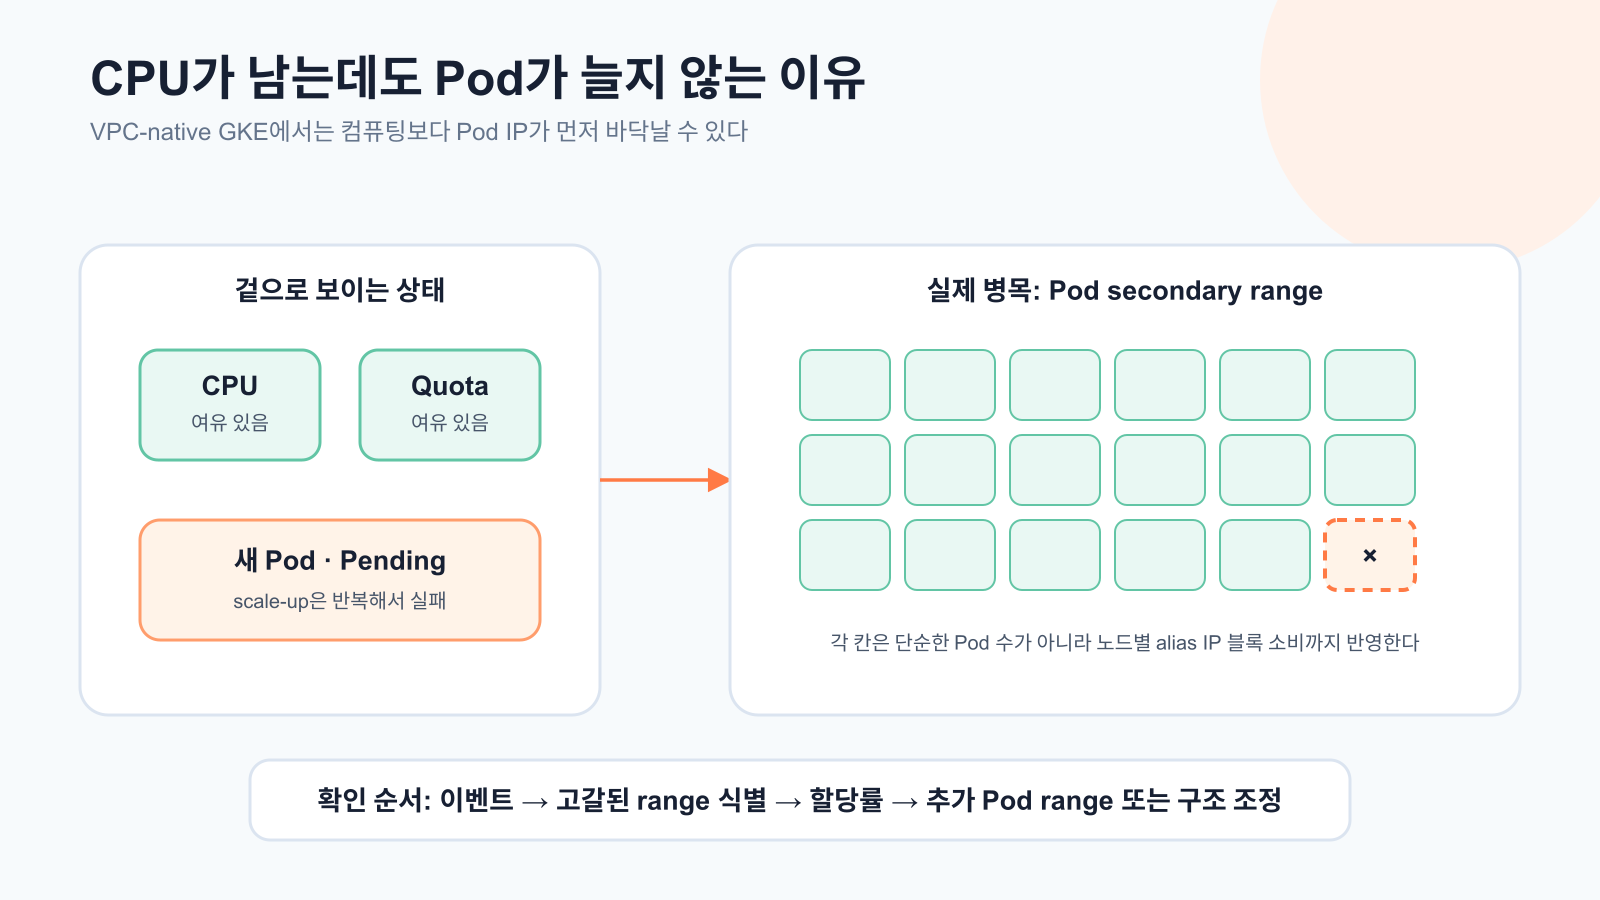
Pod가 안 늘어난 진짜 이유: GKE 보조 IP 대역 고갈
CPU나 quota가 아닌 VPC-native GKE의 Pod secondary range 고갈로 scale-up이 실패한 사례와 진단 순서, 장기 CIDR 계획을 설명합니다.
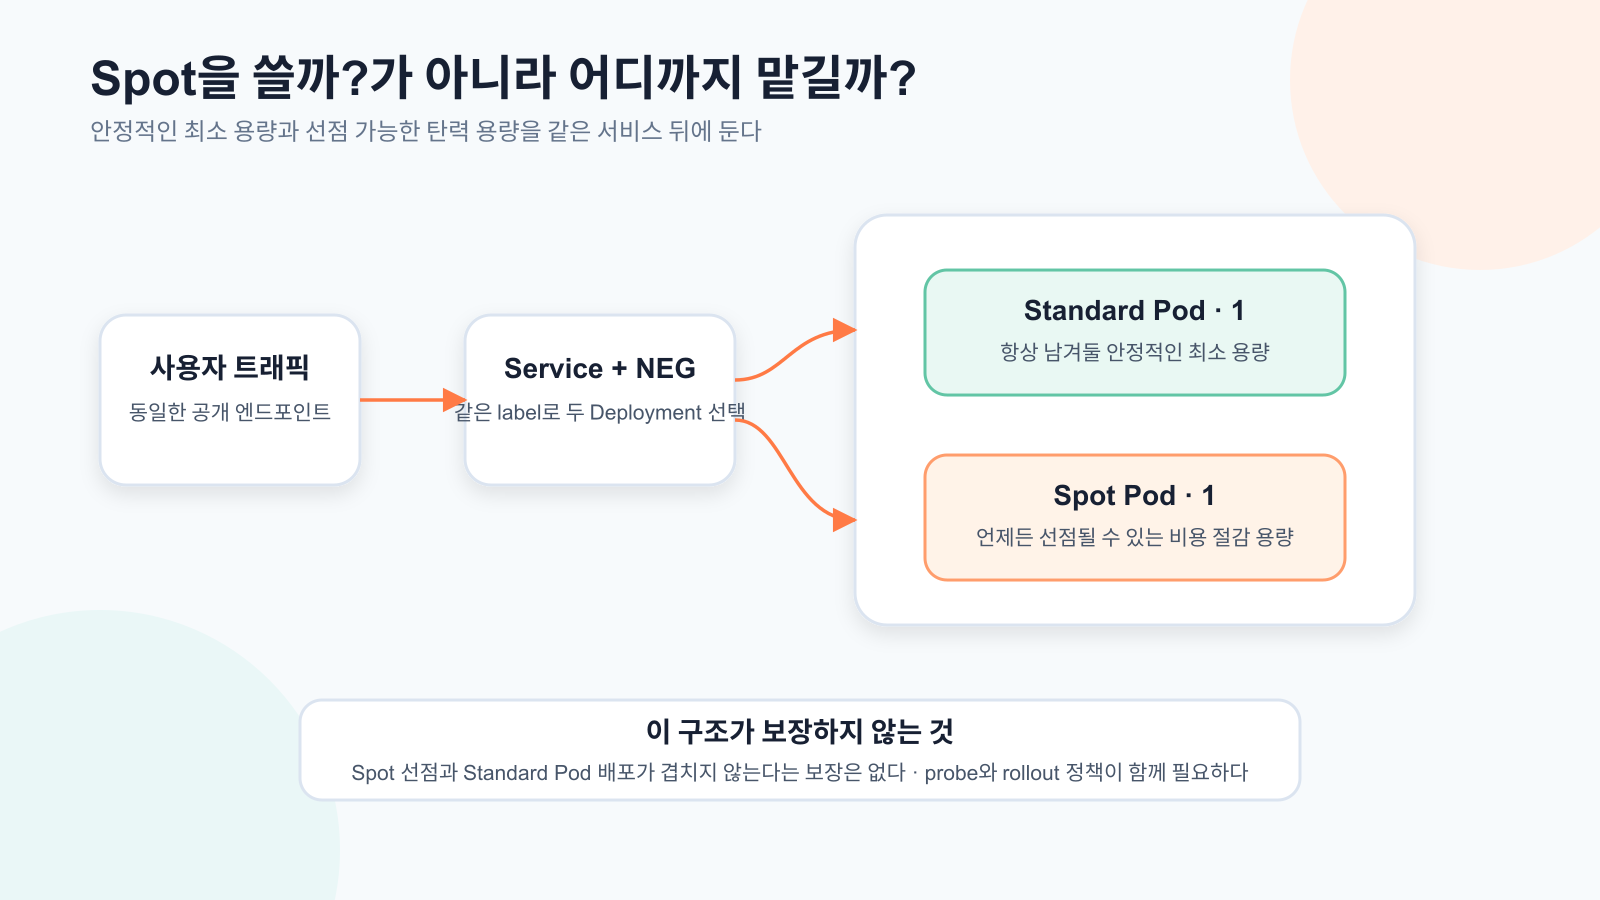
GKE Autopilot에서 Spot과 일반 Pod를 함께 운영한 이유
일반 Pod로 안정적인 최소 용량을 유지하고, 당시 약 1/7 비용의 Spot Pod를 트래픽 증가 시 자동 확장한 운영 구조와 조건을 정리합니다.

Vertex AI Context Caching과 Priority PayGo, 실제로 얼마나 빨라질까?
Vertex AI의 Context Caching과 신규 Priority PayGo 요금제가 AI 챗봇 응답 레이턴시에 미치는 영향을 Gemini 3 Flash 모델로 400회 벤치마크하여 검증했습니다. 7,500토큰 시스템 프롬프트 기준, 캐싱과 우선 처리 모두 유의미한 속도 개선 효과가 없었으며, Vertex AI의 Implicit Caching 존재를 발견했습니다.