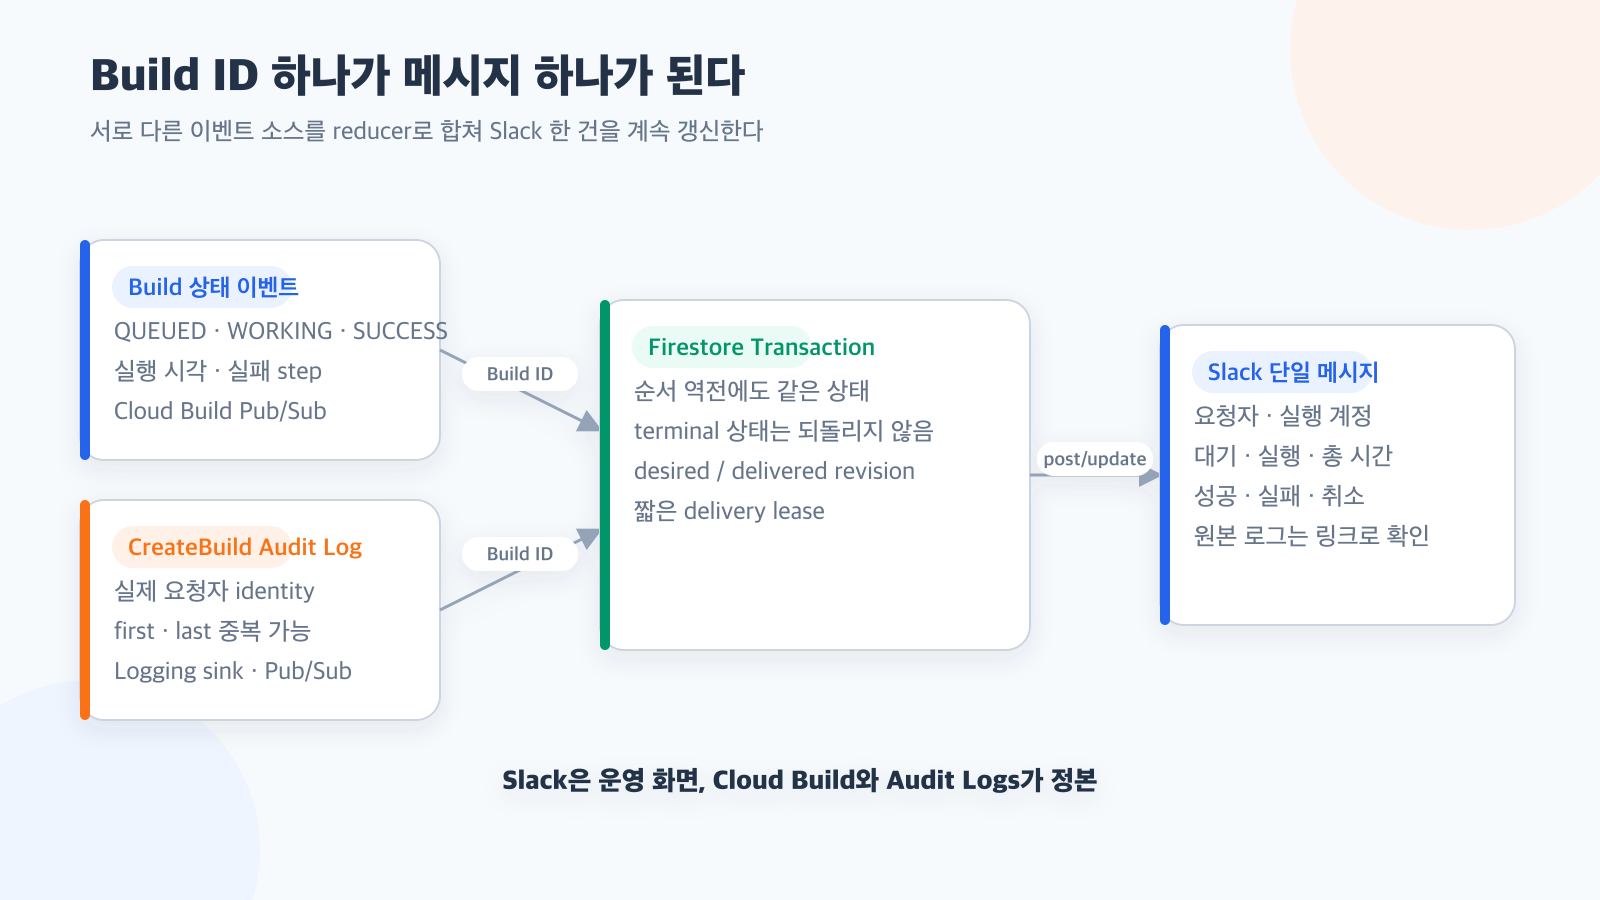
3줄 요약
- Cloud Build 상태 이벤트에는 실행 결과가 있지만 실제 요청자를 알려면
CreateBuildAdmin Activity Audit Log가 필요했다. - 서로 다른 두 이벤트를 Build ID 기준 Firestore transaction으로 합치고, desired/delivered revision과 lease로 Slack 메시지 한 건을 post/update했다.
- Pub/Sub의 중복·순서 역전과 Slack 응답 불확실성을 정상 조건으로 보고 설계해야 알림이 운영 화면으로 수렴한다.
문제: 완료 알림만으로는 부족했다
배포가 끝났다는 Slack 알림은 만들기 쉽다. Cloud Build 상태가 SUCCESS 또는 FAILURE가 되면 새 메시지를 보내면 된다. 하지만 운영자가 실제로 묻는 질문은 더 많다.
- 누가 이 build를 요청했는가
- 어떤 service account가 실행했는가
- 지금 대기 중인가, 실행 중인가, 끝났는가
- 대기와 실행에 각각 얼마나 걸렸는가
- 실패했다면 어느 step에서 멈췄는가
- 앞서 온 시작 알림과 지금의 완료 알림이 같은 build인가
상태마다 새 메시지를 보내면 한 번의 배포가 여러 줄로 흩어진다. 여러 build가 동시에 실행되면 시작과 완료의 짝을 찾기도 어렵다. 목표를 “이벤트 알림”이 아니라 build 한 건의 현재 상태를 보여주는 메시지 한 건으로 바꿨다.
요청자와 실행 계정은 다른 정보다
Cloud Build의 Build resource에는 build step을 실행하는 service account가 있다. 그러나 이것이 build를 요청한 사람이나 automation과 같지는 않다. 사용자가 service account impersonation으로 요청할 수도 있고, 다른 배포 도구가 build를 제출할 수도 있다.
실제 요청 identity는 CloudBuild.CreateBuild Admin Activity Audit Log에서 확인했다. 이 메서드는 long-running operation이므로 시작과 종료에 해당하는 감사 항목이 올 수 있고, 실제 관측에서는 종료 항목이 중복되기도 했다.
따라서 두 입력이 필요했다.
Cloud Build Pub/Sub
→ Build ID, 상태, 생성·시작·완료 시각, 실행 계정

CreateBuild Audit Log
→ Build ID, 요청자 identity, operation과 event 식별자
하나만 선택하면 정보가 불완전하다. 둘을 Build ID로 합쳐야 요청자와 실행 결과를 같은 화면에 보여줄 수 있다.
이벤트 도착 순서를 가정하지 않았다
Audit Log가 먼저 올 수도 있고 build 상태가 먼저 올 수도 있다. terminal 상태가 저장된 뒤 늦은 WORKING 이벤트가 재전달될 수도 있다. 같은 Audit operation의 last 항목이 여러 번 올 수도 있다.
이를 HTTP 요청 순서대로 상태를 덮어쓰는 방식으로 처리하면 완료된 build가 다시 실행 중으로 보이거나 Slack 메시지가 불필요하게 반복 수정된다. reducer는 상태 순위를 명시하고 다음 규칙으로 합쳤다.
- 동일 event ID는 no-op 처리한다.
- 진행 상태는 앞으로만 이동한다.
- terminal 상태가 저장되면 늦은 진행 상태가 되돌리지 못한다.
- 서로 다른 terminal 상태가 같은 Build ID에 오면 조용히 선택하지 않고 충돌로 처리한다.
- 요청자 정보는 delegation 원본, principal email, principal subject, unknown 순으로 더 신뢰할 수 있는 값을 선택한다.
같은 이벤트 집합이라면 도착 순서가 달라도 최종 표현이 같아야 한다. 이것이 알림 서비스의 핵심 계약이었다.
Firestore에는 최소 상태만 저장했다
Build ID를 문서 ID로 사용하고 transaction에서 현재 상태를 읽어 reducer 결과를 썼다. 별도의 이벤트 history collection은 만들지 않았다. 정본 이력은 이미 Cloud Build와 Audit Logs에 있기 때문이다.
상태 문서에는 다음 정도만 필요했다.
- Build ID, 상태, 안전하게 허용한 workload 식별자
- 요청자와 실행 service account
- 생성·시작·완료 시각과 제한된 실패 step 정보
- 처리한 Audit event ID와 operation 정보
- Slack channel과 message timestamp
- desired revision, delivered revision, delivery lease
- 완료 뒤 자동 삭제할 TTL
전체 build log, source archive, Secret, 임의 substitution과 원본 Audit payload는 저장하거나 Slack으로 보내지 않았다. 운영 알림의 편의를 이유로 새로운 민감정보 복제본을 만들지 않는 경계다.
desired revision과 delivered revision
Firestore transaction이 새 표현을 만들면 desiredRevision을 올린다. Slack에 그 표현이 성공적으로 반영되면 deliveredRevision을 같은 값으로 올린다.
desired = 5, delivered = 4
→ 최신 상태는 저장됐지만 Slack에는 아직 이전 표현

desired = 5, delivered = 5
→ 저장 상태와 Slack 표현이 수렴
여러 Pub/Sub 요청이 동시에 같은 Build ID를 처리할 수 있으므로 짧은 delivery lease도 사용했다. 한 worker가 Slack 전달을 맡는 동안 다른 worker는 같은 revision을 중복 전송하지 않는다. lease가 만료되면 재시도 worker가 이어받을 수 있다.
이 구조는 Firestore와 Slack을 하나의 원자적 transaction으로 만들지는 못한다. 대신 둘 사이의 차이를 명시적인 상태로 표현하고 결국 수렴하게 한다.
가장 까다로운 경우: Slack post는 성공했는데 응답을 못 받았다
네트워크 timeout이 발생하면 두 가능성이 있다. Slack이 메시지를 만들기 전에 실패했거나, 메시지는 만들어졌지만 클라이언트가 성공 응답을 받지 못했을 수 있다. 무조건 재시도하면 같은 build 메시지가 두 개 생긴다.
최초 메시지에 Build ID metadata를 넣고, post 시도 시각은 남았지만 message timestamp가 없는 상태에서는 Slack history에서 같은 metadata를 검색해 기존 메시지를 복구했다. 찾으면 새로 post하지 않고 그 메시지를 update한다.
이런 “모호한 성공”은 외부 API를 다루는 delivery 시스템에서 흔하다. idempotency key를 직접 지원하지 않는 API라면 결과물을 다시 찾을 수 있는 식별자를 함께 저장해야 한다.
Slack에는 무엇을 보여줄까
메시지는 처음에는 요청 또는 실행 중 상태로 만들어지고 후속 이벤트가 올 때 같은 글을 수정한다.
- build 상태와 대상 workload
- 실제 요청자와 별도의 실행 계정
- Build ID와 Cloud Console 링크
- 생성·시작·완료 시각
- 대기 시간, 실행 시간과 총 경과 시간
- 실패 상태라면 실패한 step ID와 정수 exit code
상세 로그를 자연어로 추측해 옮기지 않았다. 실패 step 정보가 없으면 원인을 만들어 내지 않고 상태와 원본 Build 링크만 보여줬다. Slack은 빠르게 상황을 파악하는 화면이고, 공식 실행 증적과 상세 원인은 Cloud Build에서 확인한다.
ACK와 retry 경계
모든 오류를 Pub/Sub 재시도로 돌리면 영구적으로 잘못된 payload가 반복된다. 반대로 모든 오류를 ACK하면 Firestore나 Slack의 일시 장애 때 상태를 잃는다.
- 비대상 이벤트와 복구 불가능한 형식 오류: ACK
- 정상 처리와 이미 반영된 중복: ACK
- Firestore 일시 오류, Slack rate limit과 네트워크 오류: retry
- identity나 terminal 상태 충돌: 운영자가 확인할 영구 오류로 분리
Cloud Run 호출은 IAM 인증된 Pub/Sub push와 내부 ingress로 제한했고, push identity와 runtime identity를 분리했다. Pub/Sub 호출 계정은 Firestore나 Slack Secret에 접근할 필요가 없다.
운영 검증에서 확인한 것
성공 build와 실패·취소 같은 terminal 상태, 요청자 Audit first/last, 상태 이벤트의 순서 역전을 fixture로 검증했다. 실제 활성화는 delivery disabled 상태에서 envelope와 상태 저장을 먼저 확인한 뒤 Slack writer를 열었다.
실제 카나리에서는 상태 이벤트와 Audit 이벤트가 거의 동시에 도착해 delivery lease가 한 번 경합했고, 한 요청이 재전달된 뒤 같은 메시지 한 건으로 수렴했다. 이 결과는 재시도가 실패가 아니라 설계된 정상 경로일 수 있음을 보여줬다.
지금 다시 한다면
처음부터 알림 메시지 모양보다 정규화 이벤트와 reducer의 대수적 성질을 먼저 테스트한다. 같은 입력을 두 번 적용해도 결과가 같은지, 모든 순열로 적용해도 같은 상태가 되는지, terminal 상태가 되돌아가지 않는지를 property test에 가깝게 검증할 것이다.
또한 Slack delivery를 켜기 전에 실제 Pub/Sub envelope를 저장하지 않는 disabled consumer로 충분히 관찰한다. 이벤트 계약을 추측한 채 외부 메시지부터 보내면 중복과 민감정보 노출을 동시에 만들 수 있다.
핵심은 Slack API 사용법이 아니다. 서로 다른 정본에서 온 비동기 사실을 하나의 최소 상태로 합치고, 외부 화면이 그 상태에 수렴하게 만드는 방법이다.