3줄 요약
- 짧게 생성·삭제되는 GKE Pod와 이름이 재사용되는 Node의 영향을 알아보려면 현재
kubectl get결과만으로는 부족했다. - Pod binding/delete와 Node create/delete Audit Log를 UID·발생 시각 중심 reducer로 합쳐 Firestore의 조회 가능한 현재 상태로 투영했다.
- 중복·순서 역전·stale replay를 견디려면 TTL, watermark, bootstrap과 “언제부터 신뢰할 수 있는가”라는 운영 계약이 함께 필요하다.
Monitoring 알림 뒤에 남은 질문
“Spot Node가 선점됐다”는 알림은 사건의 시작을 알려준다. 하지만 운영자가 다음으로 알고 싶은 것은 그 시점에 어떤 Pod가 그 Node에 있었고, replacement가 어떻게 진행됐는지다.
현재 cluster를 조회하면 이미 새 Node와 새 Pod로 바뀌어 있을 수 있다. 짧게 존재했던 Pod는 사라졌고, Node 이름은 나중에 다른 VM 세대에 재사용될 수도 있다. 원본 Audit Log를 매번 검색해 시간 조건과 UID를 수동으로 맞추는 것은 느리고 재현하기 어렵다.
그래서 로그를 무한히 복사하는 저장소가 아니라, 운영 질문에 바로 답할 수 있는 Pod placement와 Node lifecycle의 현재 투영 상태를 만들었다.
허용한 이벤트는 네 종류뿐이었다
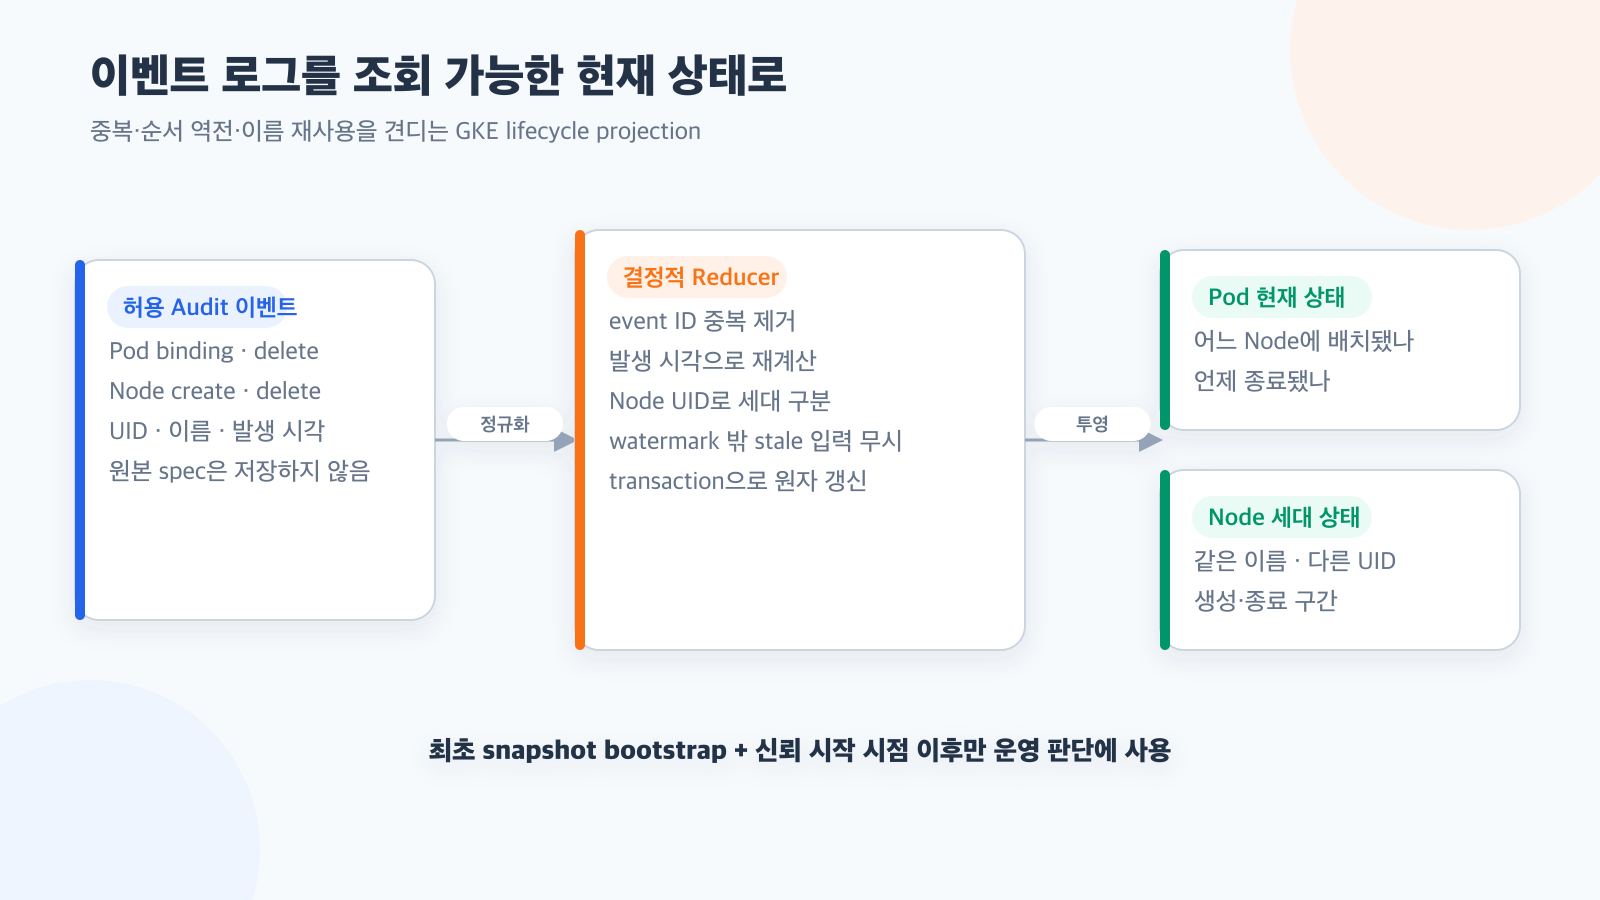
Kubernetes Audit Log 전체를 저장하지 않았다. 필요한 상태 전이를 만들 수 있는 네 method만 Logging sink로 전달했다.
- Pod binding create: Pod UID가 어느 Node에 배치됐는지
- Pod delete: 그 Pod UID의 placement가 언제 끝났는지
- Node create: Node 이름에 어떤 UID 세대가 시작됐는지
- Node delete: 그 UID 세대가 언제 끝났는지
parser는 project, cluster, namespace, Pod name/UID, Node name/UID, source timestamp와 원본 LogEntry를 해시한 event ID만 남겼다. Pod spec, 환경 변수, annotation, Secret·ConfigMap 참조와 원본 payload는 상태 저장소나 애플리케이션 로그에 복사하지 않았다.
관측 시스템은 보안 경계를 넓히기 쉽다. “나중에 필요할지도 모른다”는 이유로 원본을 저장하기보다, 답하려는 질문에 필요한 필드부터 allowlist하는 편이 안전하다.
Event log와 projection은 역할이 다르다
Audit Logs는 어떤 일이 있었는지 보존하는 정본이다. Firestore projection은 현재 질문을 빠르게 답하기 위한 파생 상태다.
Audit Logs: 변경 불가능한 사건 기록
Projection: 사건들을 reduce한 조회 모델
projection 문서에는 Pod UID별 scheduled/ended 시각과 Node, Node 이름별 UID 세대의 created/ended 구간을 저장했다. 원본 사건 이력이 필요하면 Audit Logs를 보고, “특정 시각에 이 Node에 있던 active Pod” 같은 운영 질의는 projection에서 계산한다.
둘의 역할을 분리하면 projection이 손상돼도 정본 로그를 기준으로 다시 설계할 수 있고, projection에는 짧은 TTL을 적용할 수 있다.
중복 이벤트를 멱등하게 만들기
Pub/Sub은 동일 메시지를 다시 전달할 수 있다. 같은 Pod delete가 두 번 왔다고 종료가 두 번 발생한 것은 아니다. logName + insertId 같은 원본 식별자를 해시해 event ID를 만들고 문서가 이미 같은 event를 반영했으면 no-op 처리했다.
같은 event ID인데 UID나 발생 시각이 다르면 하나를 임의로 고르지 않았다. 이는 중복이 아니라 데이터 충돌이므로 영구 오류로 분리했다. 멱등성은 모든 불일치를 숨기는 것이 아니라 “같은 사건의 같은 재전달”만 흡수하는 계약이다.
도착 순서가 아니라 발생 시각으로 계산한다
delete가 create보다 먼저 도착할 수 있고, 오래된 binding이 늦게 재전달될 수도 있다. 요청 수신 순서대로 필드를 덮어쓰면 active 상태가 부활하거나 종료 시각이 뒤로 밀린다.
Pod 상태는 가장 이른 유효한 scheduled event와 ended event를 event time 기준으로 선택했다. Node는 lifecycle event를 시간순으로 정렬해 UID별 generation을 다시 계산했다. 같거나 모호한 시각에서는 event ID를 결정적 tie-breaker로 사용했다.
이렇게 reducer가 저장된 작은 사건 집합에서 상태를 재계산하면 같은 입력 집합은 처리 순서와 무관하게 같은 결과가 된다.
Node 이름과 UID 세대를 분리한 이유
Kubernetes에서 사람이 보는 Node name은 다시 나타날 수 있다. 같은 이름만 key로 쓰면 이전 VM과 새 VM의 수명이 한 객체처럼 이어진다. 선점 사건 시점의 Pod를 찾을 때 잘못된 세대에 연결될 수 있다.
그래서 문서 key는 Node name을 사용하더라도 내부에는 UID별 generation을 유지했다.
node-a
  generation 1: uid-111, 09:00 ~ 09:24
  generation 2: uid-222, 09:25 ~ active
특정 시각의 Node 상태는 createdAt <= eventTime < endedAt을 만족하는 generation을 고른다. UID 없는 delete가 오면 그 시각에 active였던 가장 가까운 generation에 결정적으로 연결하고, 다음 create가 이전 generation의 종료 경계를 보완할 수도 있게 했다.
Watermark와 TTL은 한 쌍이다
종료된 Pod 상태는 짧은 기간, 종료된 Node 세대는 더 긴 기간 보존한 뒤 TTL로 지웠다. 그런데 Pub/Sub retention이 TTL보다 길거나 과거 메시지를 무심코 replay하면, 이미 TTL로 사라진 delete보다 오래된 create만 다시 들어와 종료된 객체를 active로 부활시킬 수 있다.
이를 막기 위해 세 가지를 함께 맞췄다.
- Pub/Sub 미확인 메시지 보존 범위를 짧은 상태 TTL보다 짧게 제한한다.
- 최신 event보다 보존 기간 이상 오래된 입력은 watermark 밖 stale event로 무시한다.
- 수동 과거 replay와 임의 seek를 운영 절차에서 금지한다.
TTL은 비용 설정만이 아니다. 어떤 과거 사건까지 reducer가 올바르게 재계산할 수 있는지를 정하는 데이터 계약이다.
최초 배포에는 bootstrap이 필요했다
Logging sink는 생성 이전 사건을 자동으로 보내지 않는다. 서비스 배포 시점에 이미 살아 있는 Node와 Pod는 create/binding 이벤트를 받지 못한 상태다. 그대로 시작하면 projection은 새 변화가 생길 때까지 불완전하다.
한 번의 live snapshot으로 현재 Node의 name/UID/creation time과 비종료 Pod의 name/UID/node/phase를 seed했다. 합성 event ID를 결정적으로 만들어 bootstrap을 다시 실행해도 중복 상태를 만들지 않게 했다.
bootstrap 뒤에는 현재 cluster UID 집합과 Firestore projection을 두 번 대조했다. 그 이후 trust watermark를 기록하고, 그 시점 이전 상태는 bootstrap 보조 정보일 뿐 SLA나 장애 이력의 신뢰 구간으로 사용하지 않았다.
Firestore transaction의 역할
Pod UID 또는 Node name 문서를 transaction에서 읽고 reducer 결과를 썼다. 같은 객체의 이벤트가 동시에 오더라도 한쪽 갱신이 조용히 사라지지 않게 했다.
Firestore에는 두 collection만 먼저 두었다. Pod lifecycle과 Node generation의 소유 목적이 명확하고 writer도 하나였다. 이 상태를 읽는 Spot episode worker는 직접 lifecycle을 다시 해석하지 않고 같은 helper로 사건 시점 generation과 active Pod를 찾는다.
운영 검증
실제 선점 사례에서 축약한 fixture로 사용자 Pod와 시스템 Pod가 사건 시점에 모두 복원되는지 확인했다. 중복, create/delete 순서 역전, Node 이름 재사용, UID 없는 delete와 stale event도 순열을 바꿔 테스트했다.
배포 후에는 bootstrap과 자연 이벤트를 통해 현재 Node와 비종료 Pod UID가 전수 일치하는지 확인했다. sink와 새 projection을 켜는 동안 기존 Monitoring 알림은 그대로 유지했다. 새 관측 경로는 정확성을 입증하기 전에 기존 경로를 대신하지 않았다.
이 시스템이 하지 않는 것
이 projection은 workload가 건강한지 판정하지 않는다. Pod가 어느 Node에 있었고 언제 종료됐는지는 알려주지만, 사용자 요청 성공률이나 서비스 가용성을 직접 의미하지 않는다. Gemini 요약, SLA 계산과 장기 사건 이력도 범위 밖으로 뒀다.
관측 데이터를 많이 모으는 것과 운영 판단을 정확히 하는 것은 다르다. 한 시스템이 사실 수집, 인과 추론, 가용성 판정과 자연어 설명을 모두 맡으면 오류 경계를 설명하기 어려워진다.
지금 다시 한다면
상태 schema를 만들기 전에 먼저 시간 질의를 문장으로 고정한다. “시각 T에 Node N의 세대는 무엇인가”, “그 세대에 active였던 Pod UID는 무엇인가”, “어느 시점 이후 결과를 신뢰하는가”를 테스트 계약으로 만든다.
그리고 bootstrap, sink 활성화, trust 설정을 하나의 배포 절차로 취급한다. 코드가 배포됐다는 사실만으로 관측 시스템이 신뢰 가능한 것은 아니다. 관측이 시작된 빈틈을 어떻게 채웠고 언제부터 완전하다고 선언했는가가 구현만큼 중요하다.