3줄 요약
- 단일 일반 Pod는 배포와 노드 작업이 겹칠 때 서비스가 잠시 비는 위험이 있었지만, 모든 복제본을 Spot으로 바꾸는 것도 적절하지 않았다.
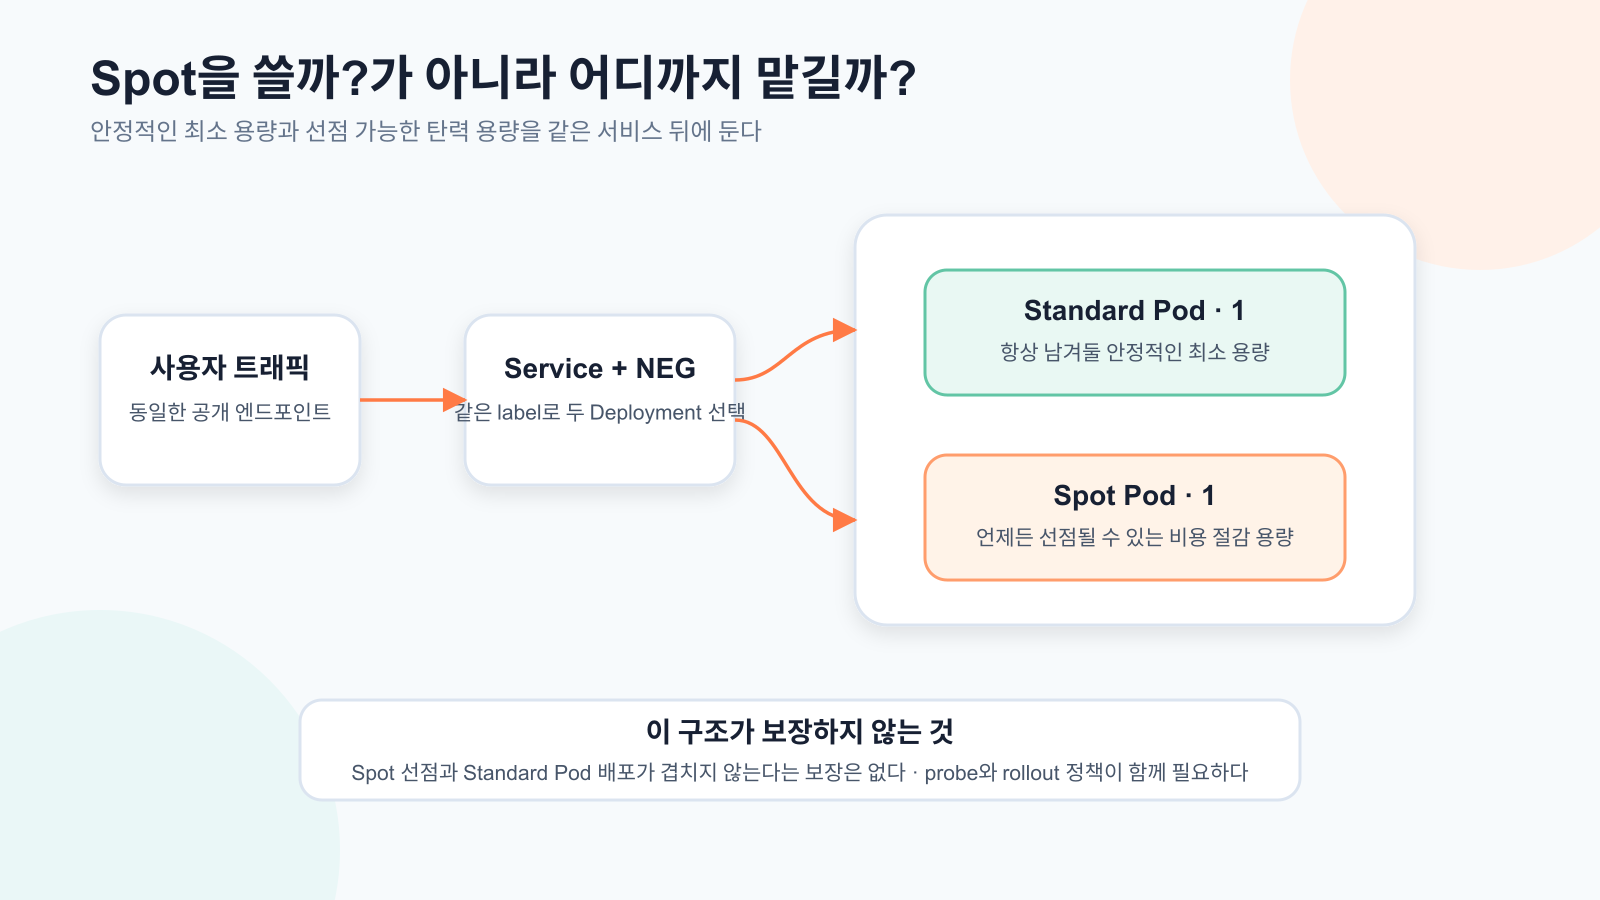
- 일반 Pod 하나와 Spot Pod 하나를 별도 Deployment로 만들고 같은 Service·NEG에 연결해 안정적인 최소 용량과 저비용 탄력 용량을 나눴다.
- Spot은 “사용 여부”보다 선점되어도 되는 복제본, 상태 외부화, probe와 rollout 정책을 함께 판단해야 한다.
배경과 제약
GKE Autopilot에서 작은 웹 서비스는 복제본 하나로도 평소 트래픽을 처리할 수 있다. 하지만 “처리할 수 있다”와 “운영 중 끊기지 않는다”는 다른 문제다. 이미지 배포, 노드 업데이트, 예기치 않은 재시작이 발생하면 대체 Pod가 준비될 때까지 엔드포인트가 비는 시간이 생길 수 있다.
복제본을 두 개로 늘리면 문제는 완화되지만 비용도 거의 함께 증가한다. 반대로 두 복제본을 모두 Spot Pod로 실행하면 비용은 낮아져도 같은 시점에 선점될 가능성을 서비스 가용성에 그대로 떠넘기게 된다.
당시 선택한 구조는 중요한 최소 용량 하나는 일반 Pod로 남기고, 두 번째 복제본은 Spot Pod로 실행하는 혼용 방식이었다. 현재 Google Cloud 문서도 Spot Pod를 언제든 중단될 수 있는 fault-tolerant workload용 선택으로 설명하며, 중요한 워크로드 전체를 Spot에만 두지 말라고 명시한다.
처음 구조와 위험
초기 구조는 Deployment 하나, replica 하나, Service 하나였다. 가장 단순하지만 다음 이벤트 중 하나만 발생해도 가용 엔드포인트가 0이 될 수 있다.
- 새 이미지로 교체하는 동안 새 Pod가 아직 Ready가 아닌 경우
- 노드 유지보수나 스케줄링 변화로 기존 Pod가 종료되는 경우
- 애플리케이션 시작 시간이 예상보다 길어진 경우
- readiness probe가 실제 준비 상태보다 일찍 성공한 경우
특히 replica가 하나인 Deployment에서 기본 rolling update 값을 그대로 믿으면 의도와 실제 반올림 결과를 확인해야 한다. maxUnavailable과 maxSurge, readiness 판정, 종료 유예 시간이 함께 동작하기 때문이다.
선택한 혼용 구조
하나의 Deployment 안에서 Pod별로 Standard와 Spot을 섞는 대신 Deployment를 둘로 나눴다.
# 안정적인 최소 용량
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-stable
spec:
  replicas: 1
  template:
    metadata:
      labels:
        app: app
    spec:
      containers:
        - name: app
          image: example/app:release
---
# 선점 가능한 추가 용량
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-spot
spec:
  replicas: 1
  template:
    metadata:
      labels:
        app: app
    spec:
      nodeSelector:
        cloud.google.com/compute-class: autopilot-spot
      containers:
        - name: app
          image: example/app:release
두 Deployment의 Pod에 같은 app label을 부여하고 Service selector가 그 label을 선택하도록 했다. Service에 연결된 NEG 관점에서는 두 종류의 Pod가 하나의 백엔드 풀로 보인다. Spot Pod가 선점되면 해당 endpoint는 빠지고, 일반 Pod는 최소 용량으로 남는다.
Deployment를 분리한 이유는 replica별 스케줄링 성격을 명시하고 배포·관측을 따로 하기 위해서다. stable과 spot의 이미지 버전이 어긋날 수 있다는 새로운 운영 위험도 생기므로, 배포 스크립트와 검증에서 두 Deployment를 하나의 릴리스 단위로 취급해야 한다.
검토한 선택지와 트레이드오프
| 선택지 | 장점 | 단점 |
|---|---|---|
| 일반 Pod 1개 | 가장 단순하고 저렴 | 재배포·장애 시 엔드포인트가 0이 될 수 있음 |
| 일반 Pod 2개 | 예측 가능한 가용성 | 작은 워크로드에서는 상시 비용 증가 |
| Spot Pod 2개 | 비용 절감 폭이 큼 | 동시 선점과 SLA 제외 위험을 모두 감수 |
| 일반 1 + Spot 1 | 안정적인 최소 용량과 비용 절감 절충 | Deployment·버전·관측을 두 벌로 관리 |
이 결론은 모든 서비스에 적용되는 정답이 아니다. 메모리 내 상태가 크거나, 종료 알림 안에 작업을 끝낼 수 없거나, 복제본 하나로 트래픽을 감당하지 못하는 서비스라면 Spot 복제본이 빠지는 순간 이미 장애다. 그 경우 일반 복제본 수를 늘리거나 작업 자체를 큐 기반으로 바꾸는 편이 맞다.
배포·선점 시 실제로 확인할 것
Readiness가 트래픽 가능 상태를 뜻하는가
프로세스가 포트를 열었다고 준비가 끝난 것은 아니다. DB와 캐시 연결, 필수 설정 로드, 내부 초기화가 끝나기 전 NEG에 들어가면 5xx가 발생할 수 있다. startup probe와 readiness probe의 역할을 나누고, readiness가 실패한 Pod는 endpoint에서 빠지는지 확인한다.
두 Deployment가 같은 버전인가
stable만 새 이미지이고 spot은 이전 이미지면 같은 URL에서 요청마다 동작이 달라질 수 있다. 두 manifest의 이미지 digest 또는 릴리스 태그를 함께 검증한다.
선점과 배포가 겹치면 어떻게 되는가
일반 Pod를 교체하는 순간 Spot Pod가 선점되지 않는다는 보장은 없다. 혼용 구조는 위험을 낮추지만 100% 무중단 보장은 아니다. 최소 두 개의 일반 복제본이 필요한 서비스인지, PodDisruptionBudget과 rollout 정책이 필요한지 별도로 판단해야 한다.
운영 결과와 한계
이 구조로 단일 일반 Pod만 있던 때보다 업데이트와 일시적인 Spot 선점에 대응할 여유가 생겼다. 동시에 모든 복제본을 일반 Pod로 운영하는 것보다는 추가 용량의 비용을 낮출 수 있었다. 다만 정확한 절감률은 리소스 요청량, 실제 실행 시간, 지역과 시점에 따라 달라지므로 이 글에서 일반화하지 않는다.
현재 manifest에서도 주요 서비스 일부에 stable과 spot Deployment가 같은 Service selector로 연결되는 패턴이 남아 있다. 그러나 서비스가 분리되고 트래픽 특성이 바뀌면 이 선택도 다시 평가해야 한다.
지금 다시 한다면
“Pod 두 개면 안전하다”로 시작하지 않고 서비스의 최소 가용 용량을 먼저 수치화한다. Spot 복제본을 모두 제거해도 목표 트래픽을 처리할 수 있는지, 종료 중 연결을 어떻게 배수하는지, cold start가 몇 초인지 측정한다. 그 다음 일반 복제본 수를 정하고 남는 탄력 용량에만 Spot을 쓴다.
또한 두 Deployment에 같은 이미지를 넣는 수작업보다 하나의 릴리스 변수에서 두 manifest가 생성되거나 검증되도록 만들 것이다. 혼용 구조의 가장 현실적인 실패는 클라우드 선점보다 두 Deployment의 설정 불일치일 수 있다.