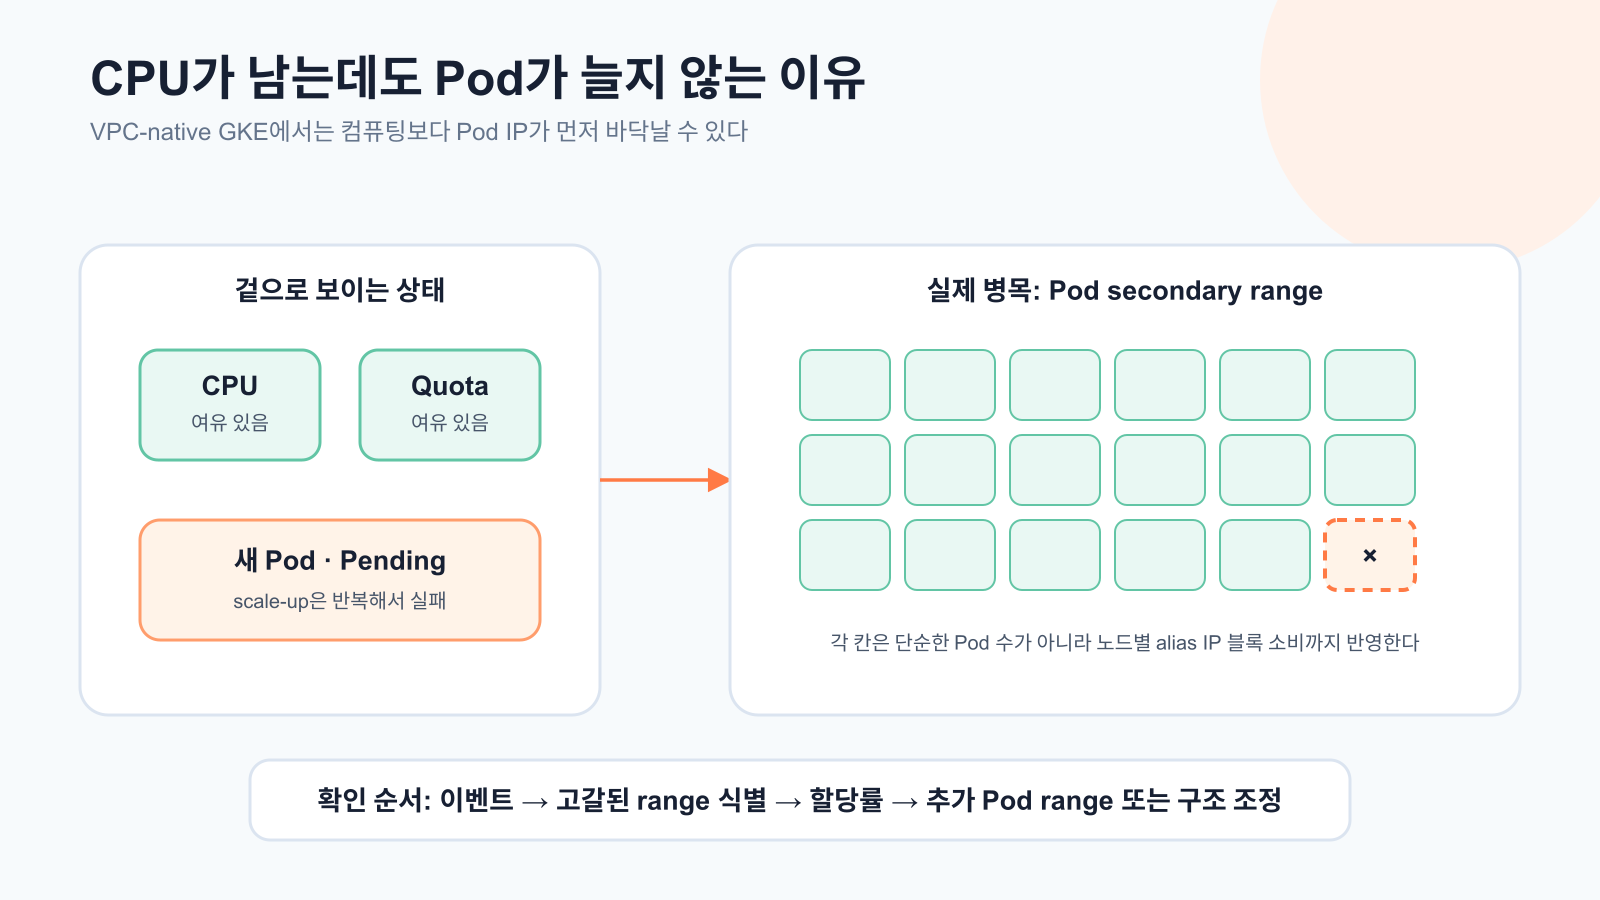
3줄 요약
- Pod가 Pending이고 autoscaler가 scale-up을 반복해도 원인이 CPU, 메모리 또는 quota라고 단정할 수 없다.
- VPC-native GKE는 Pod IP를 subnet의 secondary range에서 할당하므로, 이 대역이 고갈되면 컴퓨팅 여유와 무관하게 새 노드와 Pod를 만들 수 없다.
- 이벤트에서 고갈된 range를 식별하고 현재 할당률과 노드별 IP 블록 소비를 확인한 뒤, 추가 Pod range와 장기 주소 계획을 함께 적용해야 한다.
배경과 기대한 동작
GKE Autopilot의 장점 중 하나는 Pod의 리소스 요청에 따라 필요한 컴퓨팅을 자동으로 준비한다는 점이다. 그래서 새 Pod가 Pending이면 가장 먼저 CPU·메모리 요청이 너무 큰지, 프로젝트 quota가 부족한지, 리전 용량이 없는지를 떠올리기 쉽다.
당시에도 애플리케이션 배포는 정상적으로 제출됐고 autoscaler는 새 용량을 만들려고 했다. 하지만 Pod는 늘지 않았다. 핵심 단서는 이벤트에 남은 scale.up.error.ip.space.exhausted였다. 컴퓨팅을 만들기 전에 네트워크 주소 공간이 먼저 막힌 것이다.
왜 Pod IP가 병목이 되는가
VPC-native GKE에서 주소는 한 덩어리가 아니다.
- 노드는 subnet의 primary IPv4 range에서 주소를 받는다.
- Pod는 subnet의 Pod용 secondary IPv4 range에서 주소를 받는다.
- Service 주소는 별도 범위 또는 GKE 관리 범위를 사용한다.
Pod가 하나 늘 때마다 주소 하나만 계산하면 된다고 생각하기 쉽지만, 실제 용량 계획은 노드별 alias IP 블록 할당을 고려해야 한다. 기본 설정에서는 한 노드가 지원할 최대 Pod 수에 맞춰 더 큰 주소 블록을 예약할 수 있다. 따라서 현재 실행 중인 Pod 수만 세면 남은 scale-out 가능 노드 수를 과대평가할 수 있다.
예를 들어 공개용 예시로 Pod secondary range를 10.40.0.0/20이라고 하자. /20은 4,096개 주소를 제공하지만 이것이 곧 “Pod 4,096개를 안전하게 실행한다”는 뜻은 아니다. 노드별로 /24 블록을 할당하는 조건이라면 이론상 노드 블록은 16개뿐이다. 최대 Pod 수 설정과 GKE 모드에 따라 계산은 달라지므로 실제 클러스터 설정을 기준으로 봐야 한다.
실제로 발생한 증상
애플리케이션 관점에서는 다음처럼 보였다.
- 새 Deployment 또는 replica 증가가 제출된다.
- Pod가 Pending 상태에 머문다.
- autoscaler가 scale-up을 시도하지만 노드를 만들지 못한다.
- CPU와 일반 quota를 확인해도 명확한 부족이 보이지 않는다.
- GKE 이벤트와 IP 관련 로그에서 주소 공간 고갈 오류가 확인된다.
여기서 “subnet이 고갈됐다”와 “Pod secondary range가 고갈됐다”도 구분해야 한다. Google Cloud의 현재 문제 해결 문서는 IP_SPACE_EXHAUSTED 로그의 resourceName이 subnet 자체를 가리키는지, Pod secondary range를 가리키는지를 비교해 node IP와 Pod IP 고갈을 나누도록 안내한다.
원인 분석 순서
1. Pending Pod의 이벤트부터 본다
kubectl describe pod와 관련 GKE 이벤트에서 스케줄링 실패 이유를 확인한다. 리소스 부족, selector 불일치, taint, 볼륨, IP 공간 고갈은 모두 Pending이라는 같은 결과를 만들 수 있다.
2. 어떤 주소 범위가 고갈됐는지 식별한다
클러스터가 사용하는 primary range, 기본 Pod secondary range, 추가 Pod range를 목록으로 만든다. 범위 이름과 로그의 대상이 일치하는지 확인한다. 실제 CIDR과 네트워크 이름은 외부 장애 보고나 블로그에 그대로 공개하지 않는다.
3. 주소 수가 아니라 할당 단위를 계산한다
다음을 함께 본다.
- range 전체 주소 수
- 현재 할당률
- 노드 수와 최대 Pod 수
- 노드마다 예약되는 alias IP 블록 크기
- 같은 range를 다른 클러스터가 공유하는지
4. 단기 복구와 장기 계획을 분리한다
당시에는 기존 subnet에 추가 Pod용 secondary range를 연결해 scale-up 경로를 열었다. 장기적으로는 더 넓은 비중첩 주소 공간을 미리 예약하는 계획을 인프라 설정에 남겼다. 긴급히 범위를 하나 추가하는 것으로 끝내면 다음 확장 때 같은 문제가 반복된다.
검토한 선택지와 트레이드오프
| 선택지 | 장점 | 주의점 |
|---|---|---|
| 기존 Pod range 확대 | 주소 체계가 단순 | 환경과 범위 유형에 따라 직접 확대 제약 확인 필요 |
| 추가 Pod range 연결 | 기존 클러스터를 유지하며 확장 | discontiguous multi-Pod CIDR 운영 이해 필요 |
| 최대 Pod 수 축소 | 고정 범위에서 더 많은 노드 가능 | 새 node pool과 워크로드 이동이 필요할 수 있음 |
| 더 큰 range로 클러스터 재생성 | 장기 주소 계획을 깨끗하게 재설계 | 마이그레이션 비용과 중단 위험이 큼 |
우리 사례에서는 서비스 복구 속도와 기존 클러스터 유지가 중요했기 때문에 추가 Pod range가 현실적인 선택이었다. 그러나 이것이 주소 설계의 부채를 자동으로 없애주지는 않는다.
검증 방법과 운영 결과
대역 추가 후에는 “명령이 성공했다”가 아니라 실제 scale-up을 검증해야 한다.
- 클러스터에 추가 Pod range가 연결됐는지 확인한다.
- 이전에 Pending이던 워크로드가 새 Pod를 만들 수 있는지 확인한다.
- 생성된 Pod가 예상 범위의 주소를 받았는지 확인한다.
- Network Intelligence Center 또는 GKE IP 주소 사용량에서 각 range의 할당률을 본다.
- 운영 최대 replica와 배포 시 surge를 포함해 다음 고갈 시점을 계산한다.
추가 범위를 연결한 뒤 막혀 있던 scale-up은 정상화됐다. 그러나 가장 큰 교훈은 “클러스터가 작을 때 넉넉해 보인 CIDR”도 서비스 수, 환경 수, rollout surge, 최대 Pod 수 설정이 쌓이면 컴퓨팅보다 먼저 한계에 도달한다는 점이었다.
지금 다시 한다면
클러스터 생성 전에 서비스별 최대 replica를 더한 숫자만 쓰지 않을 것이다. 배포 중 추가 Pod, 장애 복구 여유, 노드별 alias IP 블록, 개발·운영 클러스터 공유 여부를 포함해 주소 예산을 만든다. 사용률이 임계치에 가까워진 뒤 알림을 받는 것이 아니라 예상 최대 규모 대비 잔여 노드 블록을 지표로 관리할 것이다.
또한 주소 공간은 나중에 되돌리기 어렵다. 현재 작다는 이유로 촘촘하게 자르기보다, 사내망·피어링·VPN과 겹치지 않는 넓은 RFC1918 계획을 먼저 세우는 편이 장기적으로 싸다.