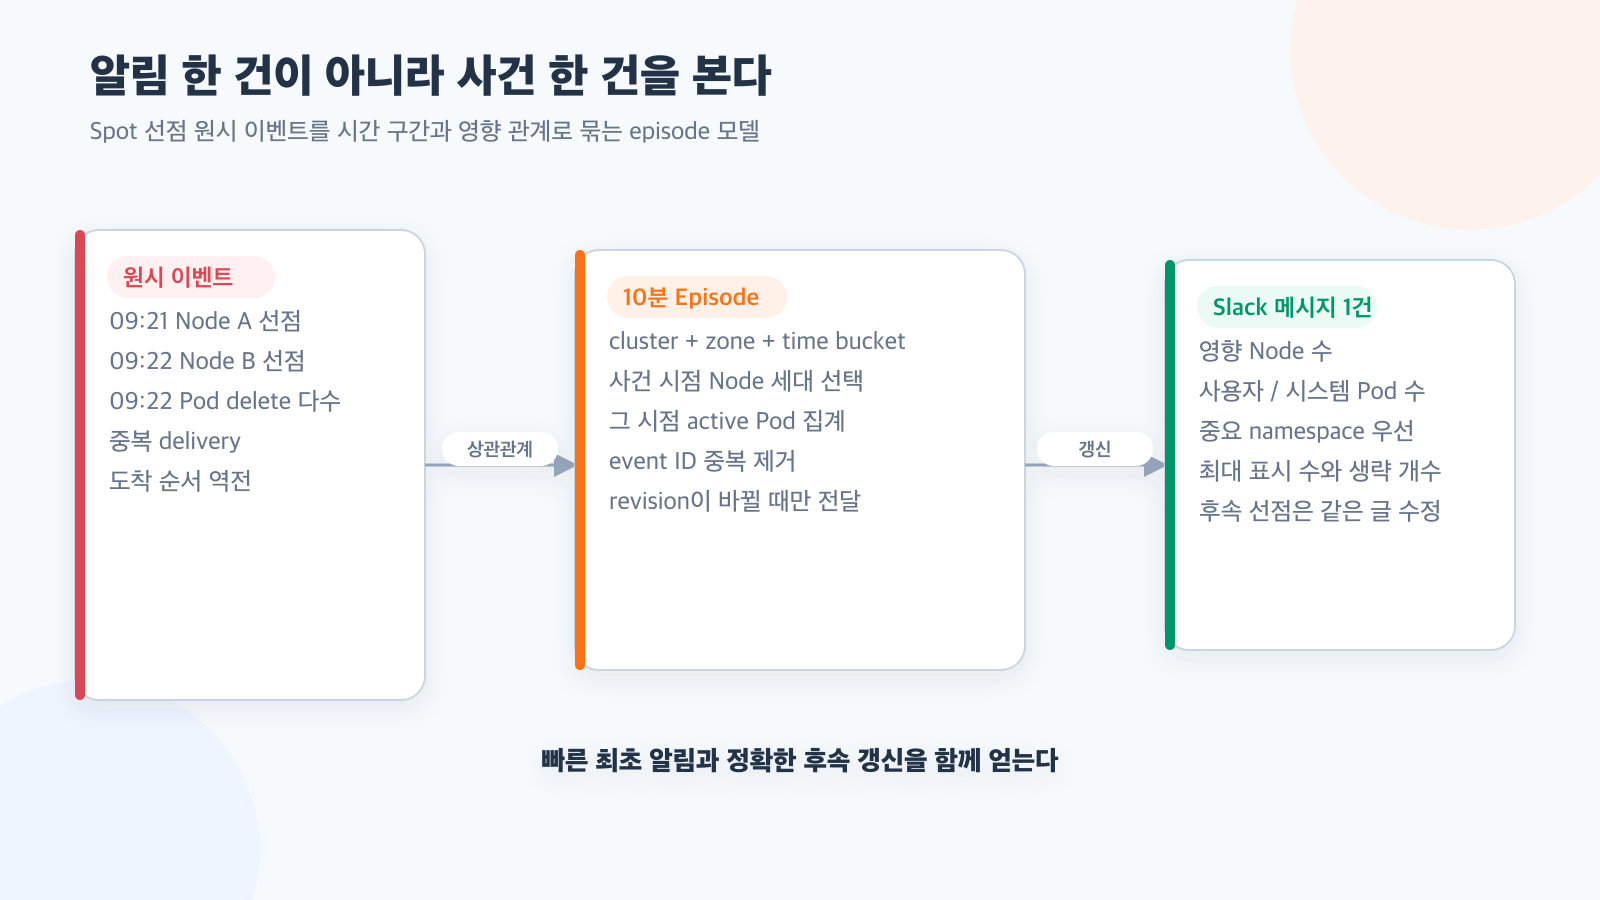
3줄 요약
- Spot 선점 이벤트 한 건마다 Slack 알림을 보내면 같은 장애의 Node·Pod 이벤트가 여러 메시지로 흩어지고 실제 영향이 보이지 않는다.
- cluster, zone과 10분 time bucket으로 episode를 만들고 사건 시점의 Node 세대·active Pod 상태를 연결해 한 메시지를 계속 갱신했다.
- 중복 제거, revision/lease, 표시 한도와 생략 개수까지 설계해야 빠른 최초 알림과 정확한 후속 정보를 함께 얻을 수 있다.
원시 알림이 말해주지 못한 것
GKE에서 Spot VM이 회수되면 Compute Engine의 선점 이벤트가 발생한다. 이벤트 한 건은 특정 instance가 언제 선점됐는지 알려준다. 그러나 운영자가 알고 싶은 것은 instance ID 자체보다 서비스 영향이다.
- 같은 시각대에 Node가 몇 대 선점됐는가
- 각 Node에 어떤 사용자 Pod가 있었는가
- 시스템 Pod와 사용자 Pod 영향은 각각 얼마인가
- 여러 선점이 하나의 용량 사건인가 서로 다른 사건인가
- 후속 정보가 도착했을 때 앞선 알림을 어디서 찾아야 하는가
Compute 이벤트, Pod delete와 replacement 로그를 각각 Slack으로 보내면 정보는 많지만 사건은 보이지 않는다. 알림의 단위를 event에서 episode로 바꾸기로 했다.
Episode의 경계
선점 이벤트의 cluster, zone과 event time을 일정한 시간 구간으로 내림해 episode ID를 만들었다.
episode key = cluster + zone + floor(eventTime / 10분)
같은 cluster와 zone에서 같은 10분 구간에 발생한 선점은 하나의 episode에 들어간다. 첫 이벤트는 즉시 메시지를 만들고, 같은 구간의 다음 이벤트는 기존 메시지를 수정한다.
10분은 보편적인 정답이 아니다. 너무 짧으면 한 사건이 여러 알림으로 갈라지고, 너무 길면 무관한 선점을 합친다. 당시 선점과 Pod 재배치 시간, 운영자가 Slack에서 확인하는 속도를 기준으로 정한 사례 값이다. 서비스별 autoscaling과 복구 시간에 맞춰 조정해야 한다.
Compute instance를 GKE Node에 연결하기
선점 Audit Log의 instance 이름에서 Node name을 얻더라도 이름만으로 과거 상태를 찾으면 위험하다. Node 이름은 재사용될 수 있기 때문이다. 앞서 만든 GKE state projection에서 선점 시각에 active였던 Node UID generation을 선택했다.
createdAt <= preemptedAt < endedAt
그 generation과 Node name에 연결되고, 선점 시각에 scheduled된 뒤 아직 ended되지 않은 Pod만 영향 대상으로 계산했다. 현재 시점의 Pod 목록이 아니라 사건 발생 시점의 placement를 사용한 것이 핵심이다.
상태 투영이 아직 따라오지 못했다면 임의로 영향 0개라고 쓰지 않았다. pending으로 저장하고 후속 처리에서 상관관계를 다시 계산할 수 있게 했다. Node가 projection에 없거나 신뢰 구간 밖이라면 “영향 확인 불가”로 표현했다. 알 수 없음과 영향 없음은 다른 상태다.
사용자 Pod와 시스템 Pod를 나눴다
모든 Pod 이름을 나열하면 중요한 정보가 묻힌다. namespace와 workload 성격을 기준으로 사용자 Pod와 시스템 Pod 수를 분리해 보여줬다. 사용자 Pod 이름은 운영자가 주로 확인하는 namespace를 먼저, 같은 우선순위 안에서는 namespace/podName 오름차순으로 정렬했다.
Slack에는 사용자 Pod 이름을 최대 10개만 표시했다. 실제 영향이 더 많다면 _외 N개 생략_을 붙였다. 이 문구가 없으면 화면의 10개가 전체인 것처럼 보인다. 실제 사례에서 중요한 namespace의 Pod가 10개 뒤로 밀린 일을 겪은 뒤 우선순위와 생략 개수를 표현 계약에 포함했다.
수집 단계에도 이벤트별 상세 개수 상한이 있다면, 생략 수는 화면에서 자른 개수뿐 아니라 저장 상한으로 남기지 못한 개수까지 더해야 한다. 그렇지 않으면 “외 15개”가 아니라 실제보다 작은 숫자를 보여주게 된다.
첫 메시지는 빠르게, 후속 메시지는 정확하게
모든 Pod delete가 도착하고 replacement가 끝날 때까지 기다리면 알림이 늦다. 첫 Compute 선점 이벤트가 오면 현재 확보된 상관관계로 메시지를 즉시 만들었다. 상태 투영이 뒤따라오거나 같은 구간의 Node가 더 선점되면 같은 메시지를 update했다.
Slack 메시지는 다음을 보여준다.
- episode 상태와 시간 구간
- cluster와 zone
- 영향 Node 목록과 사용자·시스템 Pod 수
- 우선순위가 적용된 사용자 Pod 이름 일부
- 정확한 생략 개수
- episode 식별자의 짧은 부분
이 방식은 최초 탐지 지연과 최종 정보 정확성 사이에서 하나를 포기하지 않는다. 메시지 자체가 사건의 현재 projection이 된다.
중복 이벤트와 revision
원본 LogEntry의 식별자로 event ID를 만들고, 같은 event ID는 episode에 한 번만 넣었다. 같은 ID인데 instance나 시각이 다르면 데이터 충돌로 처리했다.
episode 내용이 실제로 바뀔 때만 desiredRevision을 올렸다. Slack 전달이 성공하면 deliveredRevision을 갱신하고, 짧은 lease로 동시에 여러 worker가 같은 revision을 전송하지 않게 했다.
event 중복 → episode 변화 없음 → revision 유지 → Slack 호출 없음
새 Node 선점 → episode 변화 → revision +1 → 기존 메시지 update
Slack 최초 post가 성공했는지 응답이 모호할 때는 episode ID metadata로 history에서 기존 메시지를 찾아 복구했다. 재전달을 무조건 새 post로 만들지 않았다.
부분 실패를 상태로 표현하기
Firestore 갱신과 Slack API 호출을 하나의 transaction으로 묶을 수 없다. 그래서 delivery 상태를 pending, leased, delivered처럼 명시하고 마지막 오류 코드를 제한적으로 남겼다.
- Firestore에는 최신 episode가 있으나 Slack이 이전 revision이면 재전달한다.
- Slack rate limit이나 일시 네트워크 오류는 Pub/Sub 재시도로 복구한다.
- 형식이 잘못됐거나 대상 cluster가 아닌 영구 오류는 ACK해 무한 반복을 막는다.
- lease가 남아 있는 경합은 잠시 뒤 다시 처리한다.
중복 가능성을 없다고 가정하는 대신 중복을 흡수하고 두 시스템의 상태 차이를 관측 가능하게 만들었다.
기존 알림과 병행한 이유
새 episode worker를 만들었다고 기존 Cloud Monitoring 알림을 바로 지우지 않았다. Slack delivery를 disabled로 둔 상태에서 Pub/Sub envelope, Firestore 상태와 IAM을 먼저 확인하고, bot 권한과 Secret을 준비한 뒤에만 신규 sink를 활성화했다.
실제 자연 선점에서 신규 episode 알림과 기존 Monitoring 알림이 모두 도착하는지 비교했다. 신규 경로는 사건 발생 후 수 초 안에 첫 메시지를 만들었고, Node와 사용자·시스템 Pod 영향이 state projection과 일치했다. 중복 메시지나 Pub/Sub 적체가 없는 것도 확인했다.
관측 경로 교체는 코드 배포와 다르다. 새 경로가 실제 사건을 놓치지 않는다는 증거를 얻을 때까지 독립된 기존 경로를 유지하는 편이 안전하다.
Episode가 장애 판정은 아니다
Node가 선점되고 Pod가 재배치됐다는 사실만으로 사용자 장애가 발생했다고 단정할 수는 없다. replica가 충분하고 요청이 다른 Pod로 흘렀다면 실제 오류율은 변하지 않을 수 있다. 반대로 한 개의 중요한 Pod 종료가 큰 영향을 만들 수도 있다.
episode는 인프라 사건과 잠재 영향 workload를 묶는 관측 단위다. 최종 가용성 판정은 요청 성공률, latency, readiness와 SLI를 함께 봐야 한다. 알림 제목을 과도하게 “서비스 장애”로 단정하지 않은 이유다.
지금 다시 한다면
고정 10분 bucket 외에 sliding quiet period를 비교할 것이다. 첫 이벤트 후 일정 시간 새 선점이 없으면 episode를 닫는 방식은 경계를 자연스럽게 만들지만, 종료 timer와 재시작 내구성을 추가로 설계해야 한다. 단순성과 결정적 ID가 중요하다면 고정 bucket이 여전히 좋은 선택이다.
또한 episode에 요청 오류율이나 replica availability를 바로 합치기보다 별도의 correlation 단계로 둔다. 인프라 사실, workload placement와 사용자 영향은 신뢰도와 지연이 다르다. 한 reducer에 모두 넣으면 늦게 도착한 metric 때문에 사건 identity까지 흔들릴 수 있다.
핵심은 Slack 소음을 줄이는 요령이 아니다. 원시 이벤트를 사람이 대응할 수 있는 사건 단위로 바꾸고, 불완전한 정보를 빠르게 보여준 뒤 정확한 상태로 수렴시키는 설계다.