3줄 요약
- 브라우저와 외부 채널의 연결 수명주기는 Gateway가 맡고, AI 처리 Engine에는 여러 세션을 하나의 장기 WebSocket으로 전달한다.
- 모든 요청과 응답에
sessionId를 포함하고 Gateway의 SessionRouter가 세션을 원래 client 또는 callback으로 되돌린다. - multiplexing은 연결 수를 줄이는 대신 격리, backpressure, Engine 장애와 종료 세션 정리 책임을 Gateway에 집중시킨다.
왜 Gateway와 Engine을 나눴나
AI 챗봇의 WebSocket 서버는 서로 다른 두 종류의 일을 한다. 하나는 브라우저 연결, heartbeat, 인증과 재접속처럼 네트워크 수명주기를 관리하는 일이다. 다른 하나는 대화 문맥을 읽고 AI와 도구를 호출해 답을 만드는 일이다.
두 책임을 한 process에 두면 처음에는 단순하다. 하지만 위젯 프로토콜이나 외부 채널이 늘어날 때마다 AI Engine 배포가 함께 바뀌고, 연결 수 증가가 AI worker의 확장 단위까지 결정한다. 반대로 모델이나 검색 로직을 바꿀 때도 모든 client connection을 고려해야 한다.
Gateway를 별도 계층으로 두고 외부 연결을 종료한 뒤, 정규화한 메시지만 Engine으로 전달했다. 이렇게 하면 Gateway 구현 언어나 edge 정책을 나중에 바꿔도 Engine의 대화 처리 계약은 유지할 수 있다.
연결 구조
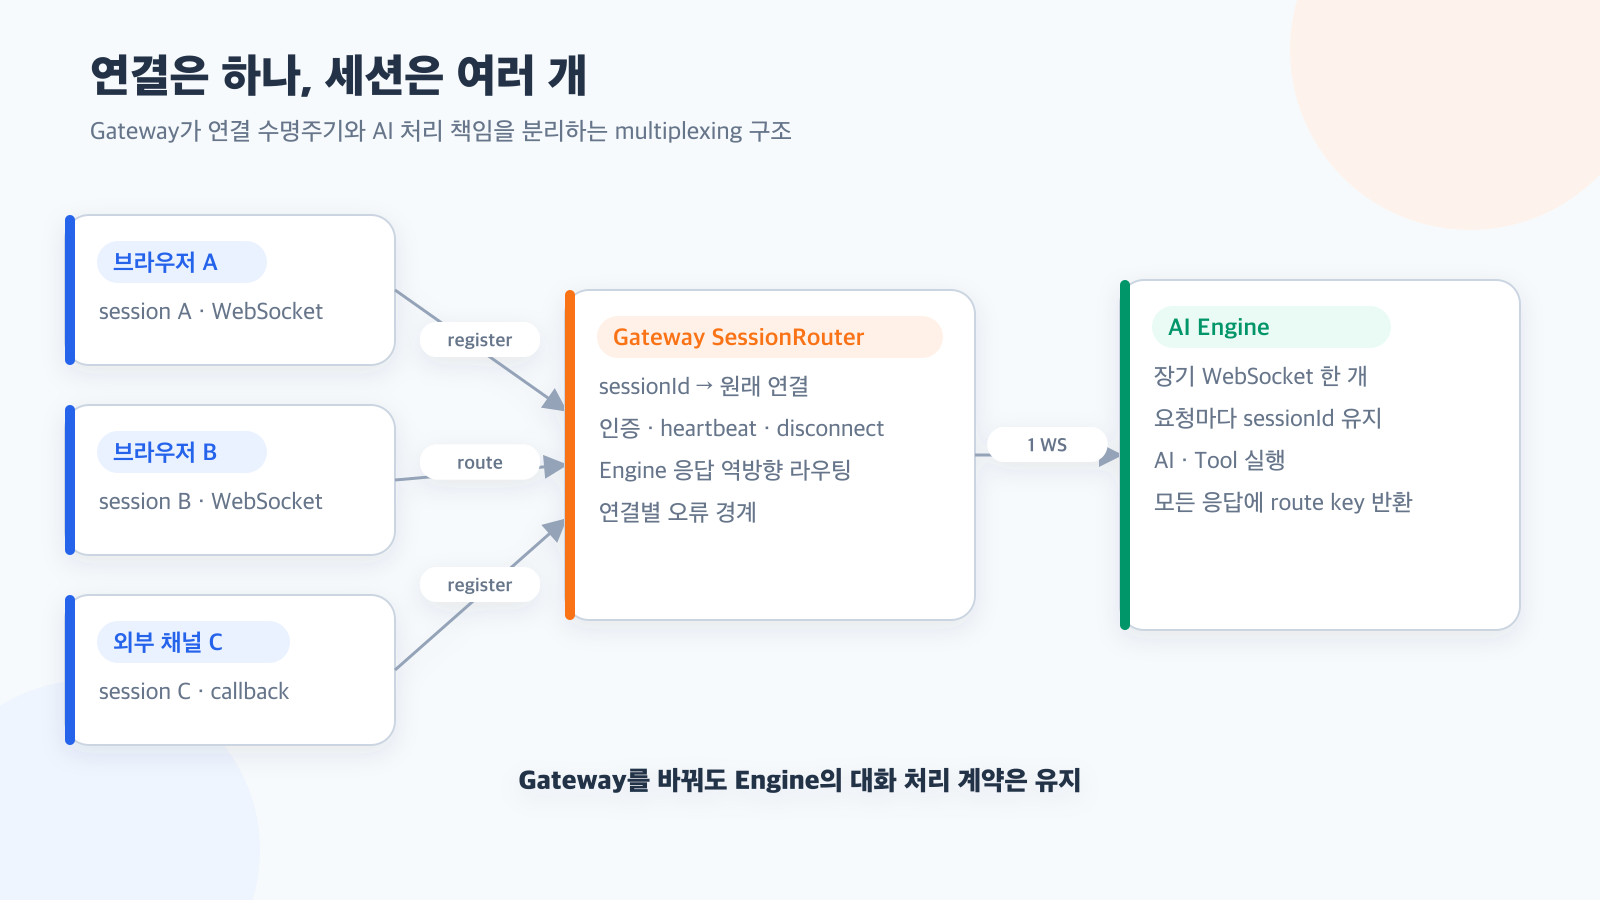
외부에서는 사용자마다 별도 WebSocket이나 callback이 있다. 내부에서는 Gateway process가 Engine과 장기 WebSocket 하나를 유지하고 여러 세션의 메시지를 그 연결에 섞어 보낸다.
Client A ──┐
Client B ──┼─ Gateway ── long-lived WebSocket ── Engine
Channel C ─┘                sessionId로 구분
연결 하나를 공유하므로 Engine은 socket 자체를 세션으로 간주할 수 없다. 요청마다 sessionId와 필요한 chatbot 식별자를 명시해야 한다. Engine의 모든 응답도 같은 routing key를 되돌려야 한다.
SessionRouter의 역할
Gateway는 client 연결이 만들어지면 sessionId → destination 관계를 등록한다. Web client라면 WebSocket 객체, 비동기 외부 채널이라면 한 번의 callback handler가 목적지가 된다.
Engine 응답이 오면 다음 순서로 처리한다.
- JSON을 파싱하고
sessionId를 확인한다. - SessionRouter에서 현재 목적지를 찾는다.
- 목적지가 살아 있으면 응답을 전달한다.
- 이미 종료된 세션이면 다른 client에 보내지 않고 전달 실패로 기록한다.
라우팅 key가 없는 Engine 응답은 broadcast하지 않는다. 한 사용자의 답이 다른 사용자에게 가는 것은 단순 오류가 아니라 데이터 격리 사고이므로, 모호할 때는 전달하지 않는 편이 안전하다.
메시지 계약을 연결과 분리했다
Client가 Engine에 직접 연결하던 시기에는 URL query에 세션 정보를 넣는 흔적이 있었다. Gateway 구조에서는 내부 Engine URL에 사용자 정보를 넣지 않고 연결 후 JSON message 본문으로 전달한다.
대표적인 message type은 연결 초기화, 일반 대화, 버튼 intent, 대화 history 초기화와 routing 종료다. 구체적인 내부 endpoint와 전체 payload는 공개하지 않지만 공통 규칙은 단순하다.
{
    "type": "message",
    "sessionId": "session-example",
    "chatbotId": "bot-example",
    "content": "사용자 질문"
}
응답도 모든 종류에 sessionId가 있어야 한다. 성공 응답만 잘 라우팅하고 error나 tool 진행 상태에 key가 빠지면 운영 중 드문 경로에서 격리가 깨진다.
연결이 끊겼을 때의 대기열
Gateway와 Engine 사이 연결도 영구적이지 않다. Engine rollout, 네트워크 오류와 process 재시작으로 끊길 수 있다. 연결이 없을 때 모든 client 요청을 무한히 메모리에 쌓으면 오래된 질문이 복구 뒤 한꺼번에 실행되고 메모리도 고갈된다.
그래서 대기열에는 개수 상한과 TTL을 둔다. 열린 연결에 즉시 보냈거나 제한 안에서 대기열에 저장했을 때만 send가 성공을 반환한다. 포화 또는 만료된 요청은 조용히 성공으로 취급하지 않고 client가 오류를 표시할 수 있게 한다.
재연결 뒤에는 만료되지 않은 항목만 기존 순서대로 flush한다. 전송 중 다시 실패하면 나머지를 한꺼번에 잃지 않도록 실패 지점부터 보존한다. 이 구조는 exactly-once를 보장하지 않는다. 대화 요청의 중복 가능성과 idempotency는 별도 message 계약에서 다뤄야 한다.
Heartbeat가 필요한 이유
WebSocket 객체가 OPEN이라고 원격 peer가 실제로 살아 있다는 뜻은 아니다. 중간 load balancer나 NAT의 idle timeout, 한쪽 process의 비정상 종료가 있을 수 있다. Gateway는 주기적으로 Ping을 보내고 이전 Ping에 Pong이 오지 않은 연결을 종료한다.
RFC 6455에서 Ping/Pong은 keepalive와 peer responsiveness 확인에 사용할 수 있다. 끊긴 연결을 계속 SessionRouter에 남겨두지 않아야 Engine 응답이 죽은 client를 향하지 않는다.
Client도 의도적으로 위젯을 닫거나 세션을 초기화할 때 자동 재연결을 막아야 한다. 네트워크 종료와 사용자가 요청한 종료는 같은 close event로 끝나더라도 다음 행동은 다르다.
Engine 장애가 모든 세션에 미치는 영향
한 Engine 연결에 여러 세션이 multiplexing되므로 이 연결의 장애 반경은 크다. 연결 수가 줄어드는 장점과 반대편 tradeoff다. 하나가 끊기면 그 Gateway process가 담당한 여러 client 요청이 동시에 대기 또는 실패한다.
이를 숨기기보다 명시적으로 관리했다.
- 연결 상태와 재연결을 한 객체가 소유한다.
- 재연결 timer는 하나만 유지한다.
- 대기열은 유한하며 메시지마다 만료된다.
- 라우팅 실패와 Engine 미연결을 구조화 로그로 구분한다.
- 의도적 shutdown은 timer와 대기열을 폐기한다.
Gateway replica가 여러 개라면 각 replica가 자체 Engine 연결과 SessionRouter를 갖는다. WebSocket client는 연결된 replica의 메모리 상태에 묶이므로 일반 HTTP처럼 요청마다 다른 Pod로 자유롭게 이동하지 않는다.
종료 세션은 양쪽에서 정리해야 한다
Client가 닫히면 Gateway의 routing entry만 지워서는 부족하다. Engine 장기 socket 안에도 sessionId별 설정 캐시와 진행 상태가 남을 수 있다. Gateway는 라우팅을 제거할 때 Engine에 종료 사실을 전달한다.
반대로 Engine 연결 자체가 닫히면 그 socket에 속한 모든 세션 설정과 timer를 정리한다. 연결 수명과 세션 수명이 다르다는 점을 양쪽에서 명시해야 한다. 이 경계를 놓쳤을 때 실제로 장기 메모리 증가가 발생했고, 후속 글에서 자세히 다룬다.
지금 다시 한다면
처음부터 프로토콜을 “socket message”가 아니라 envelope로 정의한다. 모든 요청과 응답에 message ID, session ID, type과 version을 공통 필드로 두고 schema validation을 Gateway와 Engine 양쪽에 둔다.
또한 multiplexing factor를 관측한다. Gateway별 active client 수, Engine connection별 active session 수, pending queue 크기와 라우팅 실패율을 같은 dashboard에서 봐야 한 연결 장애의 영향을 예측할 수 있다.
이 구조의 핵심은 WebSocket 한 개를 아끼는 것이 아니다. 외부 연결의 수명주기와 AI 처리 책임을 독립적으로 발전시키되, session routing이라는 명시적 계약으로 다시 연결하는 것이다.
Cloudturing에서는
Cloudturing은 여러 사용자의 실시간 대화를 안정적으로 처리하기 위해 외부 클라이언트 연결과 내부 AI 연결의 수명주기를 분리하고 있다. 두 연결을 세션 라우팅 계약으로 연계해, 각 계층이 독립적으로 연결을 관리하면서도 같은 대화 상태를 이어갈 수 있도록 실시간 대화 인프라에 적용하고 있다.