3줄 요약
- 개발 서버에서 코드 변경을 빠르게 확인하려고 PM2 reload를 실행하자, 평상시에는 멀쩡하던 Pod가 약 20초 안에
OOMKilled로 종료됐다. - reload 동안 기존 프로세스와 새 프로세스의 메모리가 겹치면서 컨테이너 limit를 순간적으로 넘은 것이 원인이었다.
- 운영 서버는 PM2 reload로 갱신하지 않고 새 컨테이너 이미지를 재배포하므로 이 문제가 운영 배포에 발생한 것은 아니며, 당시 조치도 개발 서버의 빠른 확인 흐름을 유지하기 위한 것이었다.
배경과 기대한 동작
이 사례는 운영 서버가 아니라 개발 서버에서 발생했다. 개발 중에는 작은 코드 변경을 확인할 때마다 컨테이너 이미지를 새로 만들고 배포하는 것보다, 이미 실행 중인 개발 Pod 안에서 PM2 reload를 수행하는 편이 빠르다. 기존 프로세스가 요청을 처리하는 동안 새 프로세스를 띄우고 교체할 수 있어 짧은 확인 작업에 편리했다.
운영 배포 방식은 달랐다. 운영 서버에서 실행 중인 프로세스에 PM2 reload를 수행하지 않고, 새 코드가 포함된 컨테이너 이미지를 배포해 Kubernetes가 Pod를 교체하도록 했다. 따라서 아래 문제와 조치는 운영 배포 경로의 안정성 문제가 아니라 개발 환경의 빠른 반복 작업에서만 나타난 메모리 문제로 읽어야 한다.
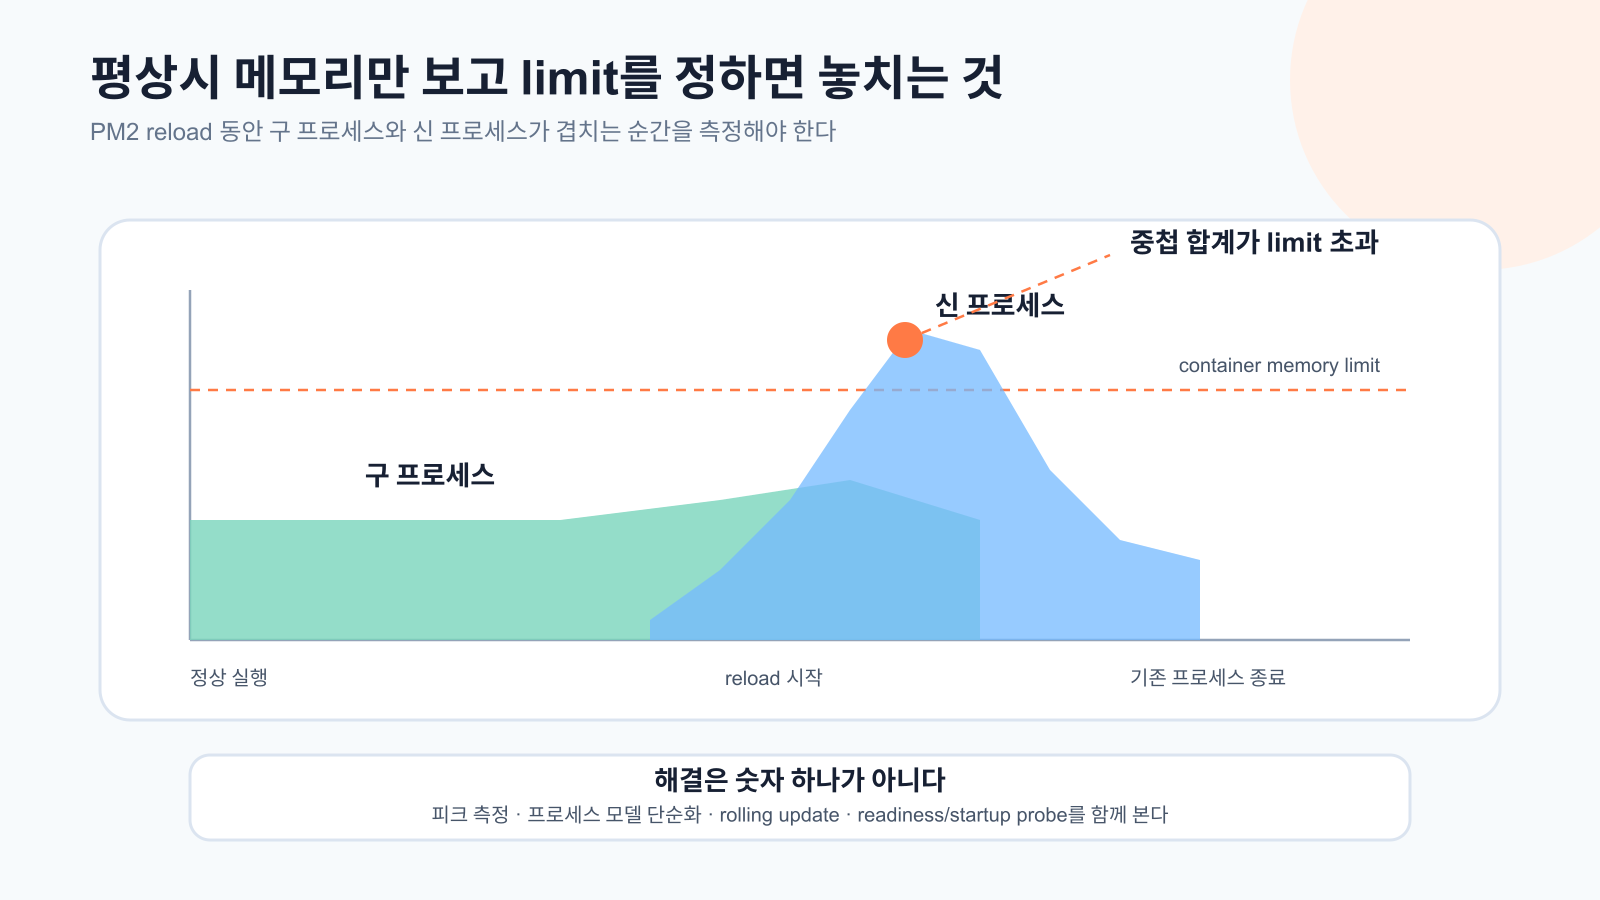
하지만 같은 컨테이너 안에서 두 프로세스가 잠시 공존한다는 사실은 메모리 limit 설계에 직접 영향을 준다. 평상시 RSS만 보고 limit를 정하면 reload 순간의 합계는 측정하지 못한다.
당시 개발 환경의 Console Pod는 평상시에는 정상 동작했지만 reload 후 짧은 시간 안에 종료됐다. Kubernetes 상태에서 종료 이유는 OOMKilled였고, 메모리 limit는 256Mi였다.
실제로 발생한 증상
- 개발 서버에서 코드 변경 후 PM2 reload를 실행했다.
- 기존 프로세스를 유지한 채 새 프로세스가 만들어졌다.
- 약 20초 안에 컨테이너가 종료되고 Kubernetes가 다시 시작했다.
- 애플리케이션 로그만 보면 명시적인 예외가 없거나 마지막 로그가 중간에 끊겼다.
- Pod의 이전 컨테이너 상태를 확인했을 때 reason이
OOMKilled였다.
이런 문제는 애플리케이션 오류처럼 보이지만 Node.js 예외 처리로 잡을 수 없다. Linux cgroup의 메모리 limit를 넘으면 커널 OOM 처리에 의해 프로세스가 종료될 수 있다. CPU limit 초과가 throttling으로 나타나는 것과 다른 점이다.
원인 분석: 정상 메모리와 전환 메모리는 다르다
간단히 표현하면 reload 동안의 최대치는 다음에 가깝다.
전환 피크 ≈ 기존 프로세스 RSS
          + 새 프로세스 시작 RSS
          + 공유되지 않는 버퍼·캐시
          + PM2와 런타임 오버헤드
Node.js heap만 확인해서도 부족하다. RSS에는 V8 heap 외에 native allocation, Buffer, 로드된 모듈, 코드 공간 등이 포함된다. 컨테이너에서 함께 실행되는 PM2 자체의 메모리도 같은 cgroup에 포함된다.
이 메모리 중첩은 개발 Pod 안에서 PM2 reload를 선택했기 때문에 생겼다. 운영에서는 새 이미지 배포로 구 Pod와 신 Pod를 교체하며, 실행 중인 운영 Pod 내부에서 PM2 reload를 추가로 수행하지 않았다. 두 흐름을 구분하지 않으면 마치 운영 배포가 PM2와 Kubernetes의 이중 reload 구조인 것처럼 오해할 수 있지만 실제 운영 방식은 그렇지 않았다.
검토한 선택지와 트레이드오프
1. 메모리 limit를 늘린다
개발 속도를 유지하는 가장 빠른 방법이다. 당시에는 개발 Pod의 limit를 256Mi에서 512Mi로 늘려 reload 피크가 limit 안에 들어오도록 했다. 그러나 측정 없이 두 배로 늘리는 것은 근본 해결이 아니다. 코드가 커지면 같은 문제가 다시 발생할 수 있고, request도 함께 조정하지 않으면 스케줄링과 실제 사용량의 차이가 커진다.
2. PM2 reload를 유지하되 피크를 줄인다
cluster worker 수, 동시 시작 수, graceful shutdown 시간, 캐시 초기화 순서를 조정할 수 있다. 개발 서버의 빠른 확인 흐름을 유지할 수 있지만 관리할 파라미터가 늘어난다.
3. 개발 환경도 이미지 재배포만 사용한다
운영과 같은 방식으로 매번 이미지를 만들고 Kubernetes가 Pod를 교체하도록 하면 PM2 reload 중첩은 사라진다. 대신 작은 변경을 확인할 때도 빌드와 배포를 기다려야 하므로 개발 피드백이 느려진다.
4. 운영 배포 방식은 그대로 둔다
운영은 이미 새 이미지 재배포와 Pod 교체를 사용하고 있었으므로 PM2 reload 문제를 해결하기 위해 운영 구조를 바꿀 이유가 없었다. 개발 환경에서 발견한 숫자를 운영 Pod의 권장 메모리로 옮기는 것도 적절하지 않았다.
적용한 해결 방법
당시 조치는 개발 Pod의 memory limit를 256Mi에서 512Mi로 올리는 것이었다. 이 변경으로 reload 중 구·신 프로세스가 겹쳐도 즉시 OOMKilled가 발생하지 않도록 여유를 확보했고, 개발자가 빠르게 변경 사항을 확인하는 흐름을 유지할 수 있었다.
여기서 512Mi는 일반적인 Node.js 권장값도, 운영 서버의 권장값도 아니다. 당시 개발 애플리케이션과 PM2 reload 방식에서 증상을 멈춘 사례 값일 뿐이다. 다른 서비스는 module 수, heap, Buffer, 동시 요청, 이미지·문서 처리 여부가 모두 다르므로 같은 숫자를 복사하면 안 된다.
검증 방법
메모리 변경 뒤에는 “Pod가 Running”인지만 보지 않는다.
- reload 전 idle과 실제 트래픽 상태의 RSS를 기록한다.
- reload 시작부터 기존 프로세스 종료까지 짧은 간격으로 container memory를 수집한다.
kubectl describe pod에서 restart count와 이전 종료 reason을 확인한다.- PM2가 새 프로세스를 준비한 뒤 기존 프로세스를 예상 시간 안에 종료하는지 확인한다.
- 같은 reload를 여러 번 반복해 피크의 분산을 본다.
- 운영 이미지 재배포 경로에는 PM2 reload 단계가 없다는 점을 배포 절차와 대조한다.
Kubernetes 공식 문서에서 memory request는 주로 스케줄링에 사용되고 memory limit는 cgroup을 통해 커널이 집행한다고 설명한다. 따라서 request를 낮게 두고 limit만 높이는 선택도 노드 압박과 QoS 관점에서 별도 검토해야 한다.
단순 증설의 한계
메모리를 늘린 뒤 문제가 사라지면 분석을 멈추기 쉽다. 그러나 다음 질문이 남는다.
- 개발 트래픽과 reload가 겹치면 얼마까지 올라가는가?
- memory leak이 있어 기준선 자체가 계속 올라가지는 않는가?
- old process가 예상 시간 안에 종료되지 않으면 두 프로세스가 얼마나 오래 겹치는가?
- 개발 피드백 속도를 위해 PM2 reload를 계속 유지할 가치가 있는가?
- limit 증가로 Pod 밀도가 낮아지거나 비용이 커지지는 않는가?
숫자를 올리는 해결은 피크가 유한하고 측정 가능할 때만 안전하다. 기준선이 계속 상승한다면 메모리 누수나 정리되지 않는 연결을 먼저 찾아야 한다.
지금 다시 한다면
개발과 운영의 실행 목적을 먼저 분리한다. 개발 서버는 피드백 속도가 중요하므로 PM2 reload를 유지하되 reload 구간의 최대 RSS를 측정하고 명시적인 여유를 둔다. 개발 중에도 이미지와 배포 경로 자체를 검증해야 하는 변경이라면 편의를 위해 reload하지 않고 실제 재배포를 수행한다.
운영은 지금처럼 새 컨테이너 이미지를 배포하고 Kubernetes가 Pod를 교체하도록 한다. 개발 서버의 PM2 reload 사례를 근거로 운영 메모리를 늘리거나 운영 프로세스 관리 방식을 바꾸지 않는다. 결국 이 사례의 핵심은 모든 환경에 같은 실행 방식을 강요하는 것이 아니라, 개발 편의를 위해 추가한 reload 경로의 순간 자원 사용량을 별도로 측정해야 한다는 점이다.